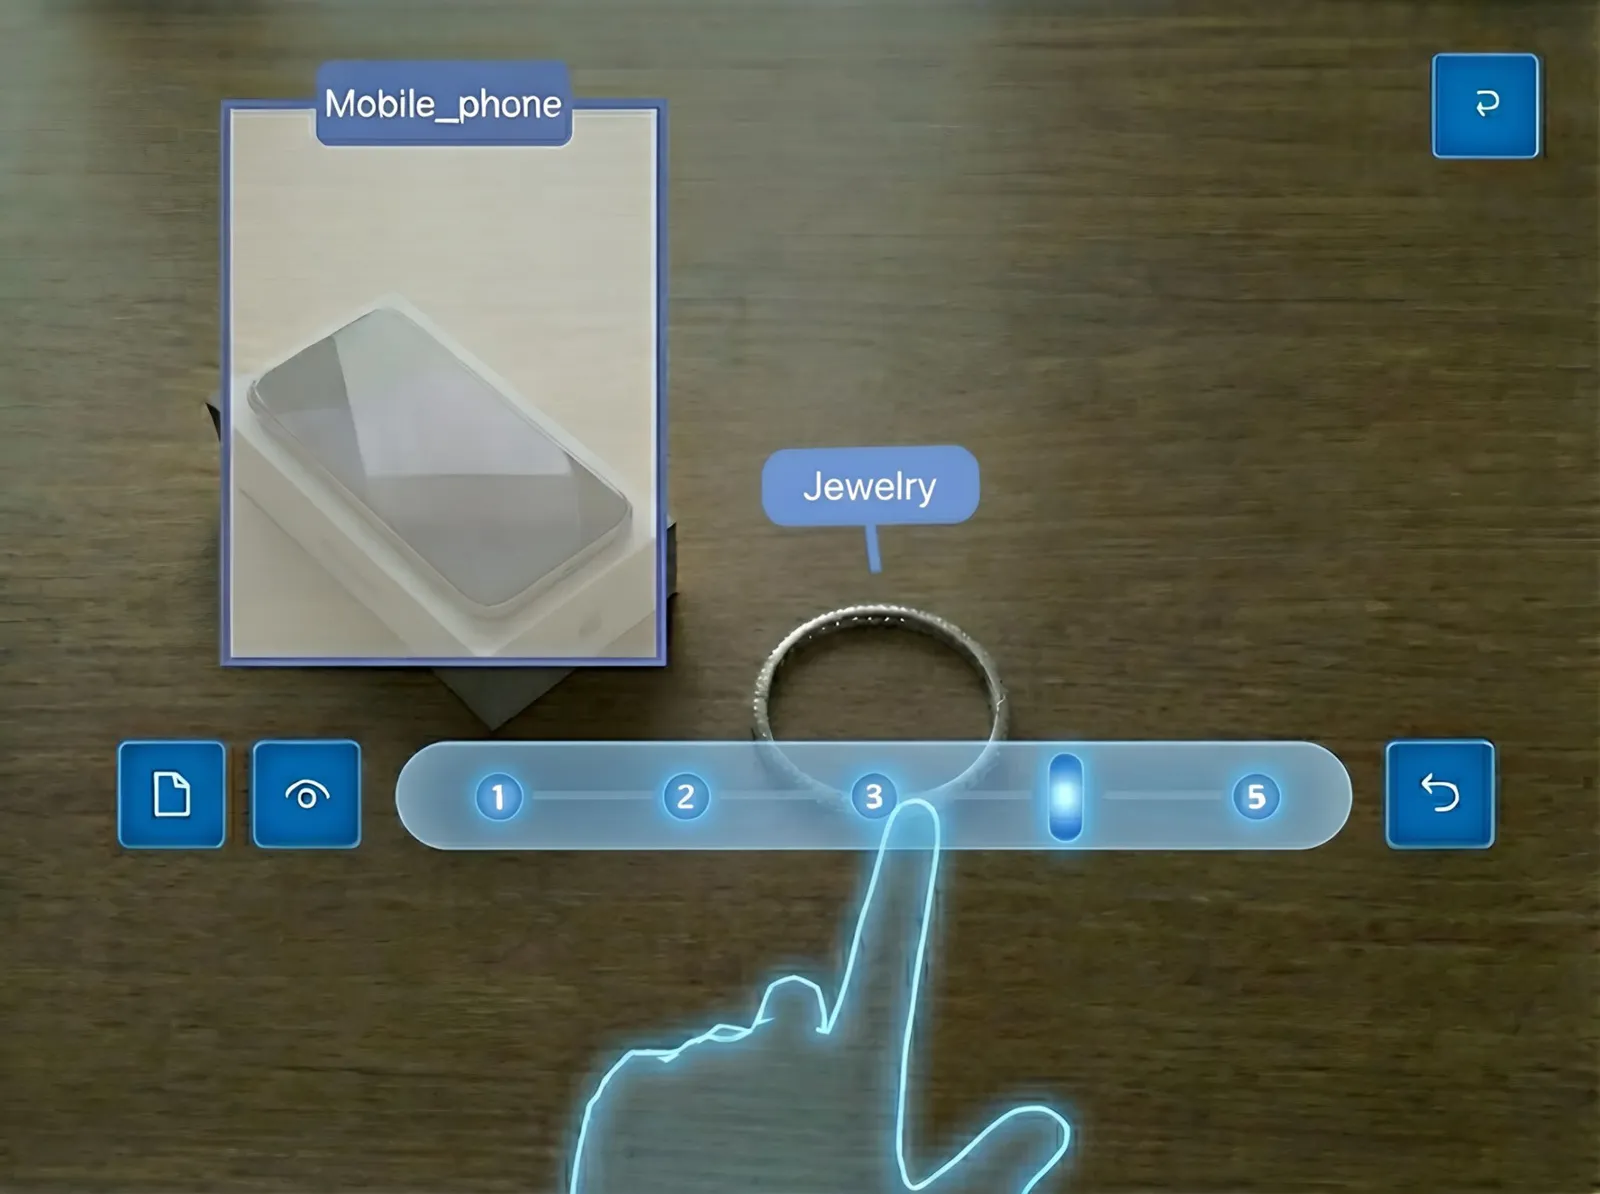
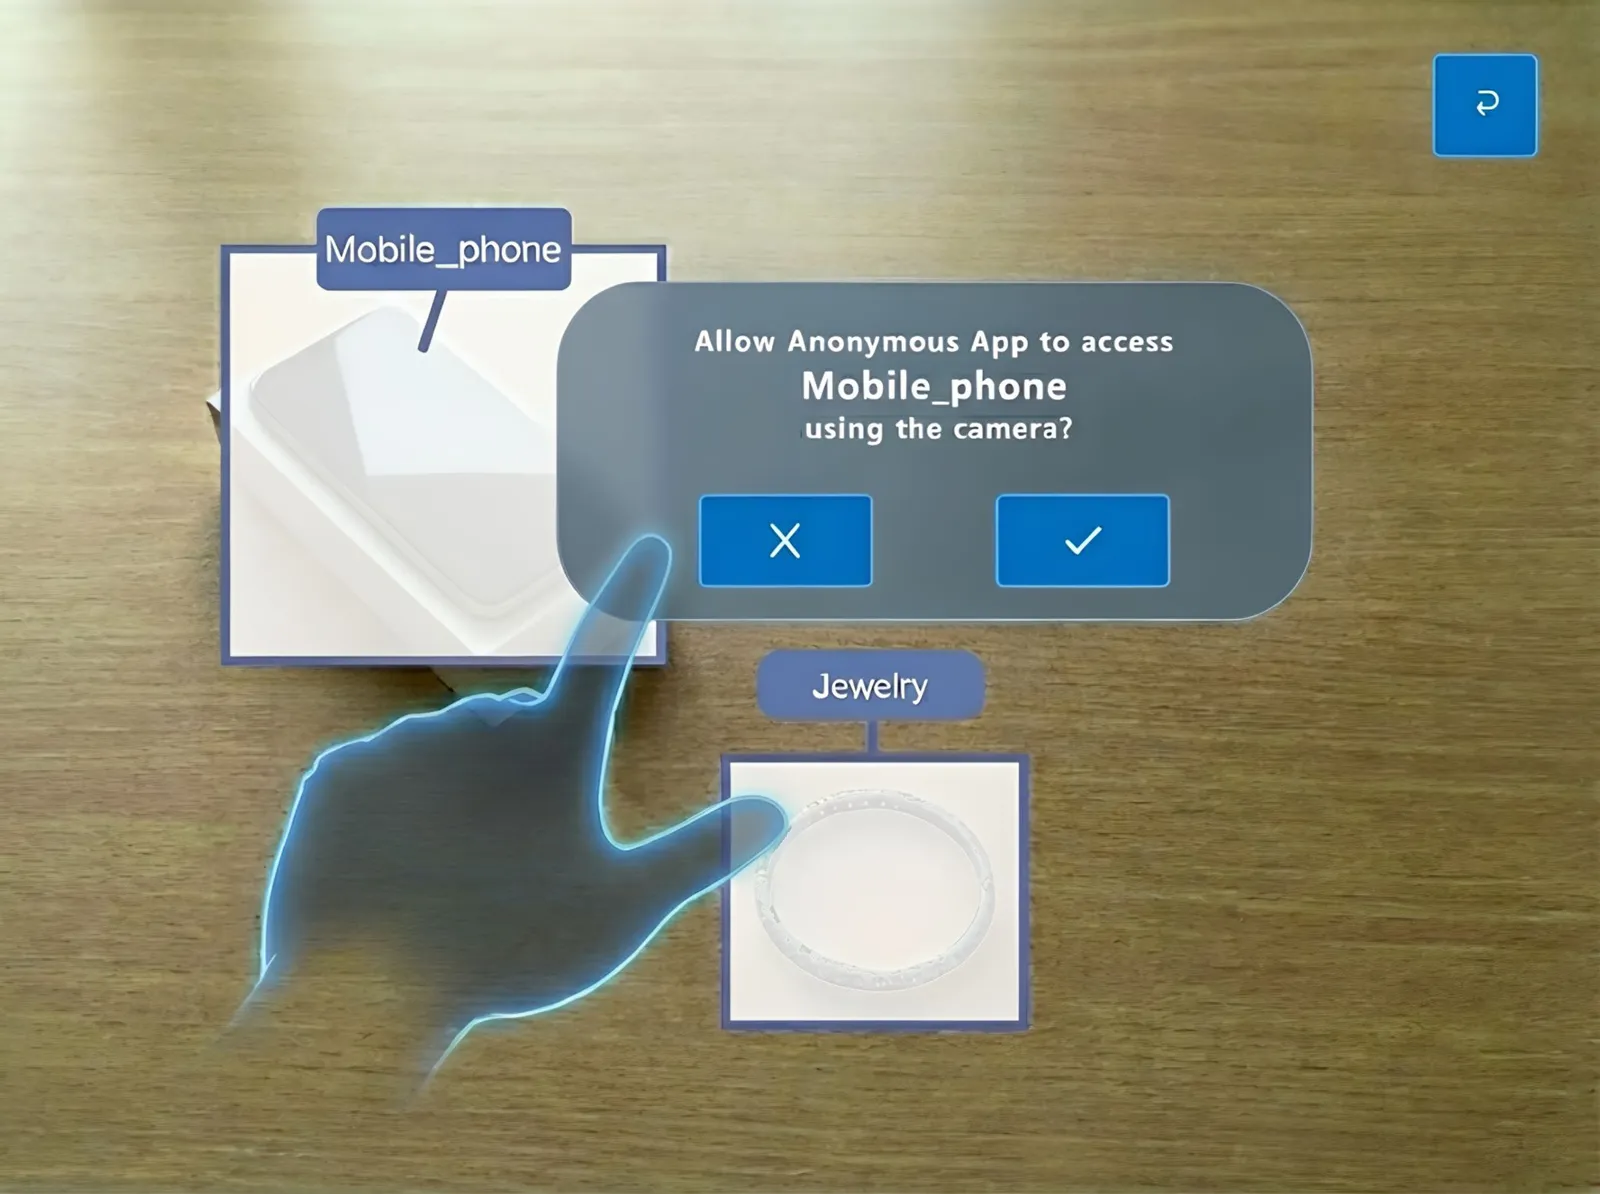
智能眼镜隐私保护系统
为 AR 眼镜前置摄像头构建细粒度视觉隐私控制。点一个物体,就能管一整组,在隐私保护与任务效用之间取得平衡。 经 24 人用户研究验证,发表于 CHI 2026。
全文约 2,700 字,阅读约 6 分钟
VisGuardian 是一套面向 AR 眼镜前置摄像头的视觉隐私控制系统,解决家庭场景里旁观者和用户自身敏感物体的泄露问题。摄像头画面里的敏感物体被实时检测,并按隐私敏感度、语义类别、空间位置自动分组。用户点其中任意一个物体,就能一次性管理一整组相关物体的可见性,既有细粒度控制的精确,又省去逐个设置的麻烦。
我以共同第一作者身份参与,负责交互设计、AR 原型开发和用户实验的设计与执行。整套交互是四步流程,检测、选择、分组应用、确认。被隐藏的物体通过图像修复从画面中移除,替换成合理的背景。
技术层面,模型在 LVIS+COCO 混合数据上微调,mAP50 达 0.6704,端侧推理延迟 14.0ms,额外电池消耗约 1.7%/小时。24 人对照实验验证了分组控制在设置速度、效率、有效性与易用性上的优势。成果以共同第一作者发表于 CHI 2026。
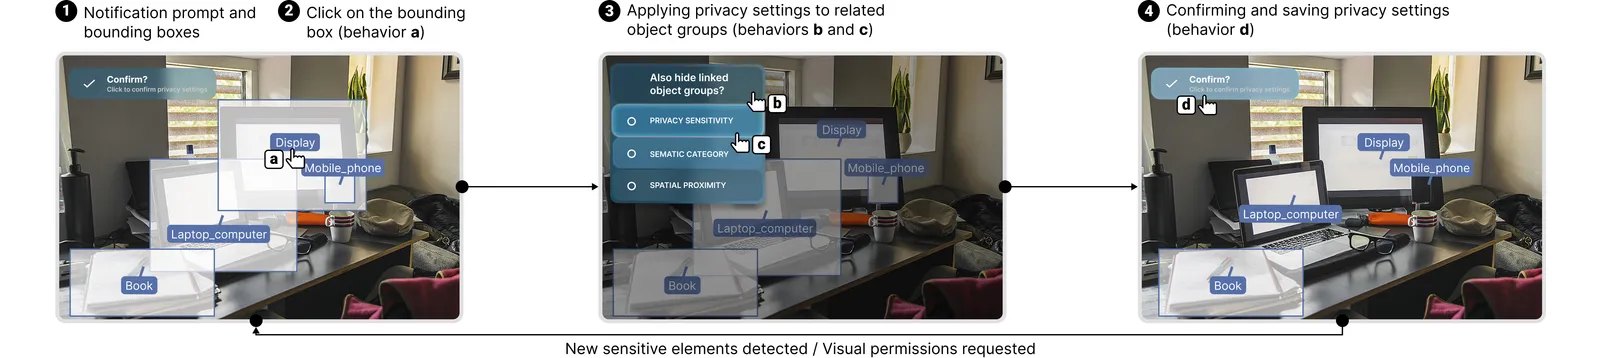
图 1 四步交互流程,检测 → 选择 → 分组应用 → 确认
为什么 AR 眼镜需要新的隐私方案
AR 眼镜上的 AI 应用要理解周围环境,前置摄像头就得一直开着。隐私问题的重点因此从“摄像头开不开”,转移到“画面里的哪些内容能交给应用”。这个矛盾在家庭环境里最明显,证件、屏幕、私人物品和任务相关物体常常出现在同一个视野里,家庭成员未必愿意这些内容被采集。
现有方案都不合适。全局开关一关,所有 AR 功能跟着失效;按房间授权,分不清同一空间里的敏感物体;逐物体设置权限,成本随物体数量上升。VisGuardian 把权限从单个物体提升到一组,点一个物体,就能批量管理一组相关物体。
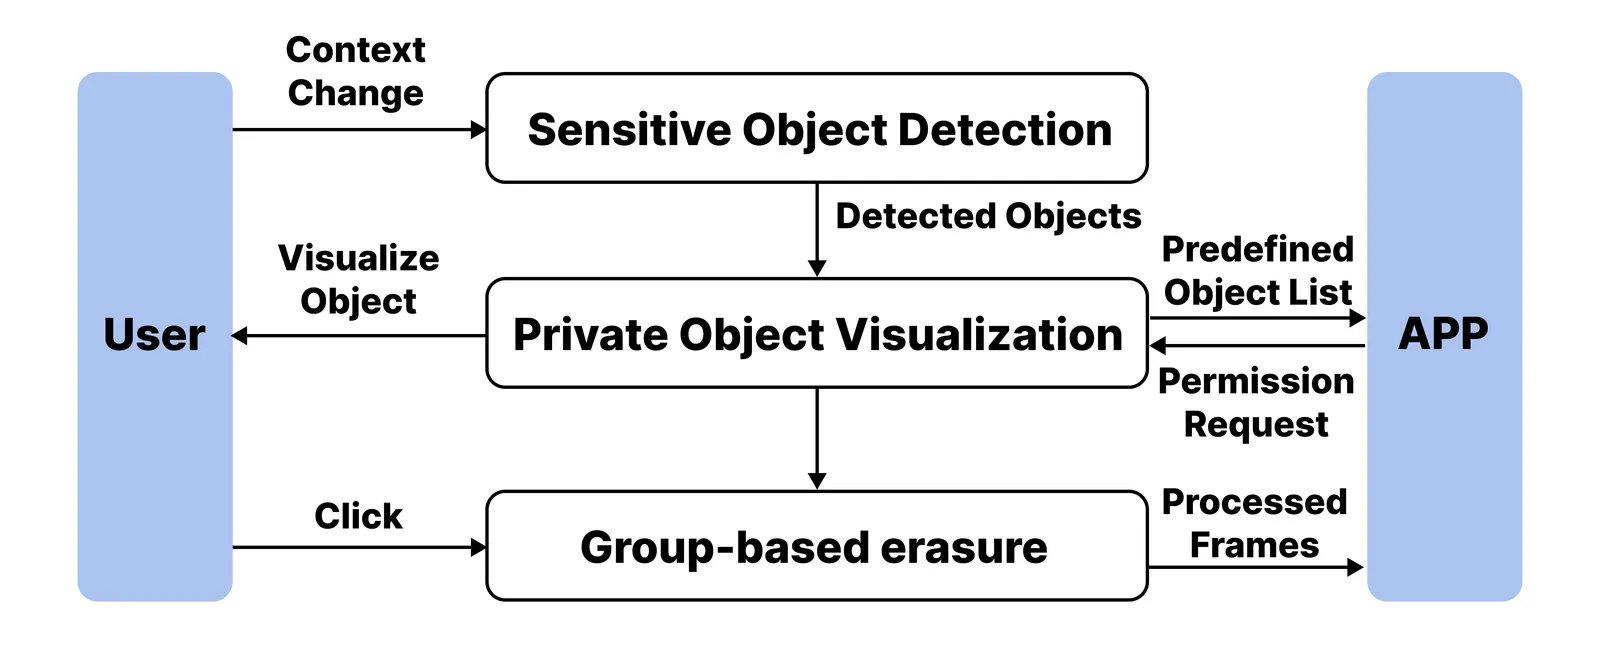
图 2 系统架构,检测 → 可视化 → 分组擦除
处理链路
检测、可视化、分组擦除构成系统的主干,端侧实时检测敏感物体,按三个维度分组,默认全部脱敏,用户按需隐藏或揭示,处理后的画面实时显示,同时发给 AI 应用。
三个维度把物体归成组
“点一个物体管一组”的前提,是系统知道怎么分组。我们借用了访问控制里“把权限放在一组对象上”的思路,用三个属性给物体分组。
- 隐私敏感度按泄露风险分级,支持“隐藏全部高风险物体”这类操作;
- 物体类别按概念归组,屏幕类、证件类各归一组;
- 空间位置按所处场景分组,适配家庭里房间、区域这类上下文。
分类学整理自既有的视觉隐私研究,再补上手机、笔记本电脑这类新出现的敏感物体,共 7 类物体组,风险分高、中、低三级。不便直接检测的隐私概念先做映射,比如“醉酒”映射到啤酒这类可检测物体,“裸露”映射到人。
四个设计目标
AR 眼镜的摄像头一直开着,权限管理不能沿用“设置一次、长期生效”的思路。我们据此定了四个设计目标。
- 权限基于画面里的内容,决定哪些视觉信息可以被处理、存储或共享;
- 隐私状态随时可感知,不打断正在做的事;
- 默认先保护敏感物体,环境变化时沿用历史设置,只对新出现的隐私物体提示;
- 设置好的偏好自动生效,不需要持续关注。
目标落在系统上是一条链路,端侧实时检测敏感物体,按三个维度分组,默认全部脱敏,用户按需隐藏或揭示,处理后的画面实时显示,同时发给 AI 应用。
交互收敛成四步
检测、选择、分组应用、确认,四步完成一次权限设置(交互流程见图 1)。关键交互决定。
- 点击任意已检测物体,面板从视野边缘浮现,不遮挡正在看的画面;
- 候选组按三个维度给出,以“内衣”为例,同类别的衣物、同空间里的常见物、同风险级的敏感物会分别成组;
- 遮蔽采用直接遮挡,不用模糊;此前的研究表明,用户认为直接遮挡更清楚、歧义更少;
- 设置完成后界面缩成一条边缘栏,只有出现新物体或用户主动操作时才重新出现。
检测模型与端侧部署
眼镜端的算力和电池都有限,检测模型要在精度和开销之间取平衡。我们在 LVIS+COCO 混合数据上微调了 YOLOv10n,参数只有 2.3M。精度更高的 YOLOv10s 体积超过三倍,不适合眼镜端的资源限制。最终模型跑在 HoloLens 2 上,端到端延迟实测 14.0ms。
遮蔽与功耗
脱敏在 3D 空间里完成,检测到敏感物体后,生成一个网格盖住检测框,画面冻结在检测那一刻。相比实时模糊着色器,这种做法更轻量,也和“直接遮挡优于模糊”的设计决策一致。
60 分钟实验里,VisGuardian 消耗 35.0% 电量,两种基线条件为 35.2% 和 35.5%,不跑检测的基线为 33.3%,差异不显著。隐私保护带来的额外功耗约 1.7%/小时。
图 3 基线,物体检测与标注覆层
图 4 基线,权限确认面板
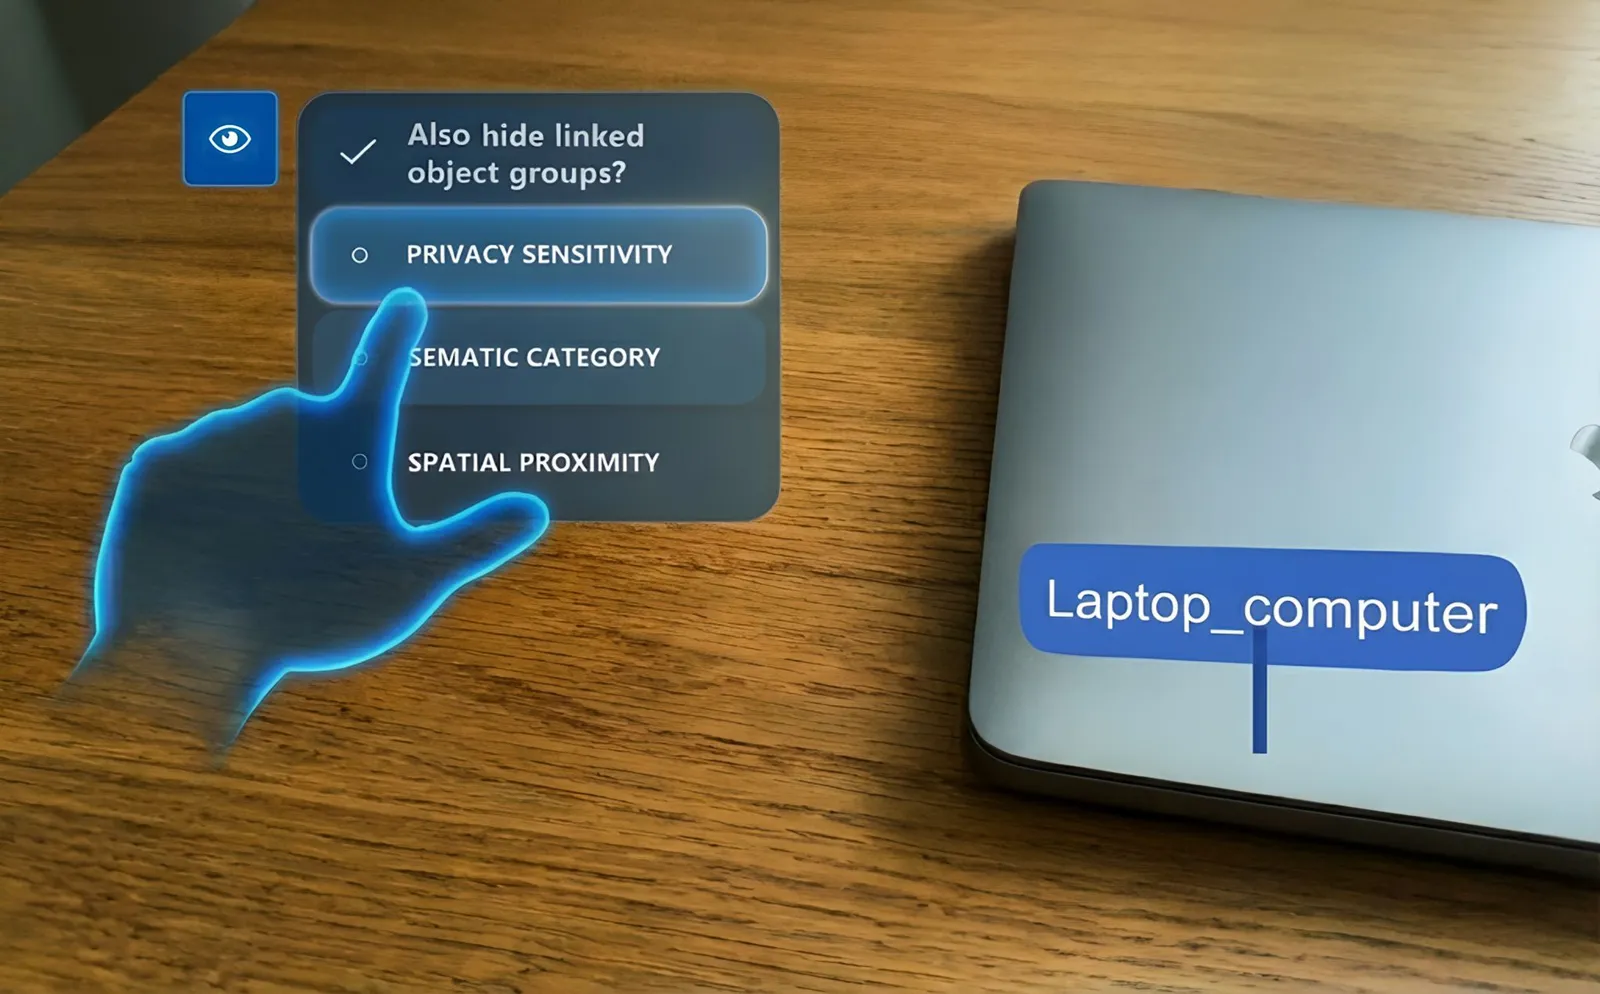
图 5 本系统,分组擦除后的视觉效果
基线对比
对照实验对比三种控制方式,本系统基于分组、逐物体设置权限(源自 Aragorn)、用一个滑块整体调节(源自 Abraham et al.)。前两张为两套基线的界面,第三张为本系统。
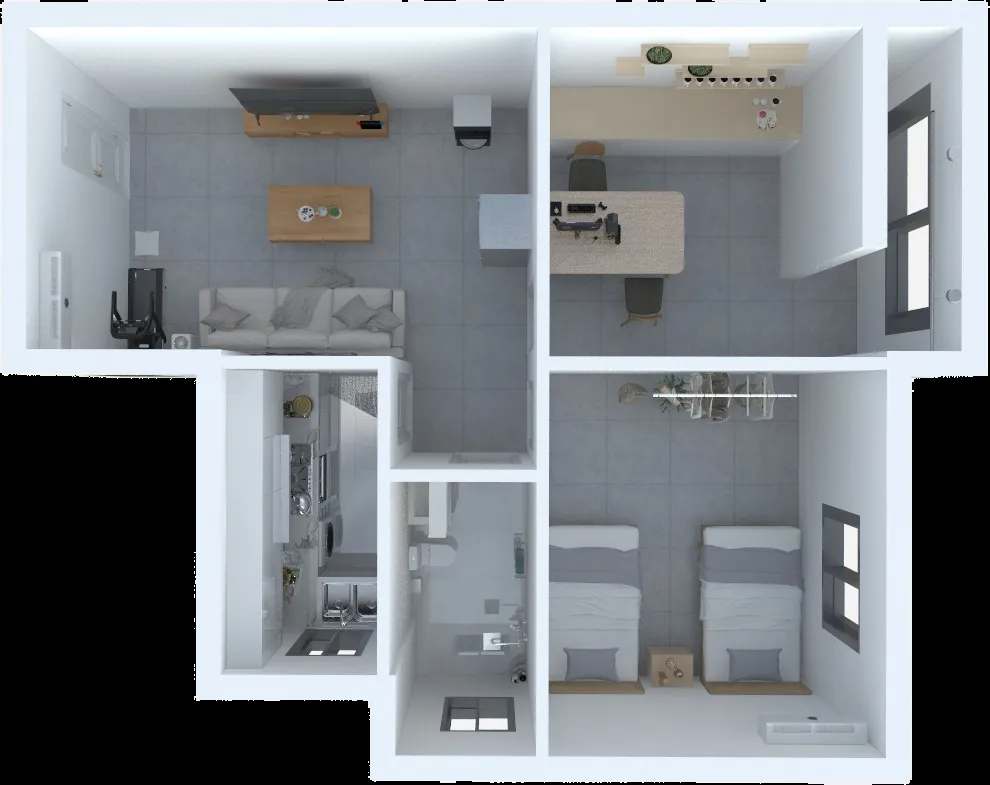
图 6 实验家居环境 3D 平面图
实验设计
我们在真实装修过的家居环境里做了 24 人的被试内对照实验,13 男 11 女,平均 24.5 岁,实验通过 IRB 审批。每位被试依次体验三种控制方式,顺序用拉丁方平衡。
任务覆盖健康与日常行为、家居生活、社交互动、工作辅助四类场景共 12 个,全部经 6 位研究者迭代打磨,既需要 AI 辅助,又伴随明确的隐私风险。全程约 60 分钟,结束后有 15 分钟半结构化访谈,被试获得 100 元报酬。
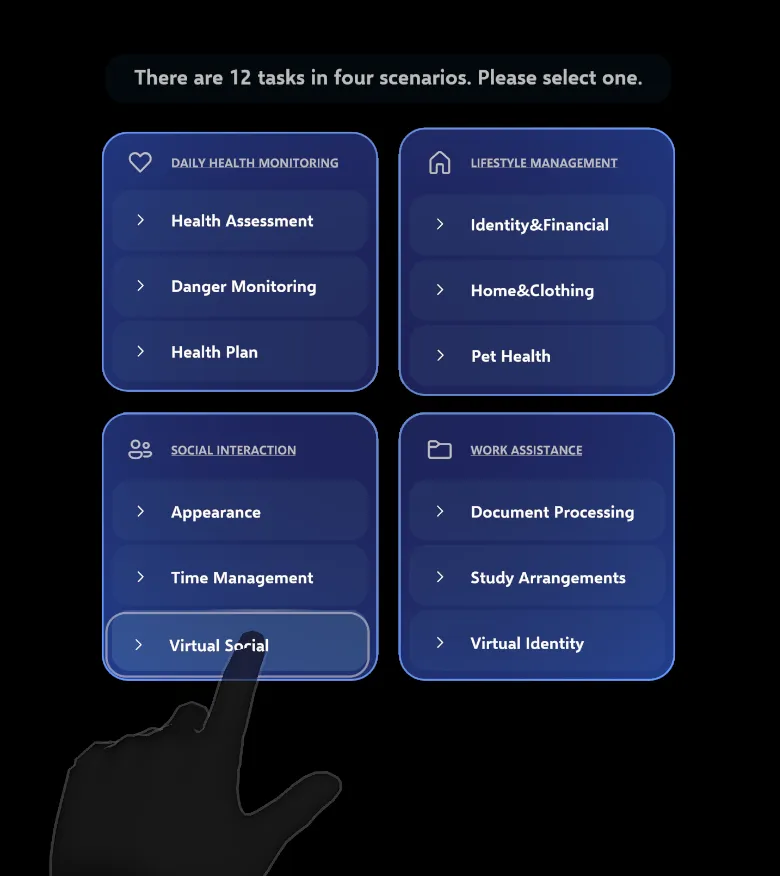
图 7 任务选择菜单
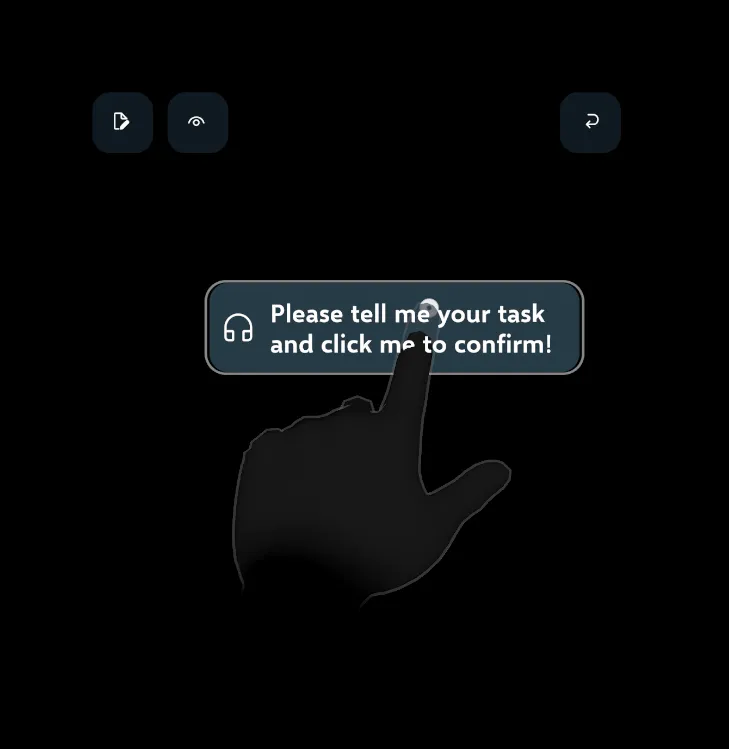
图 8 手指点击提示
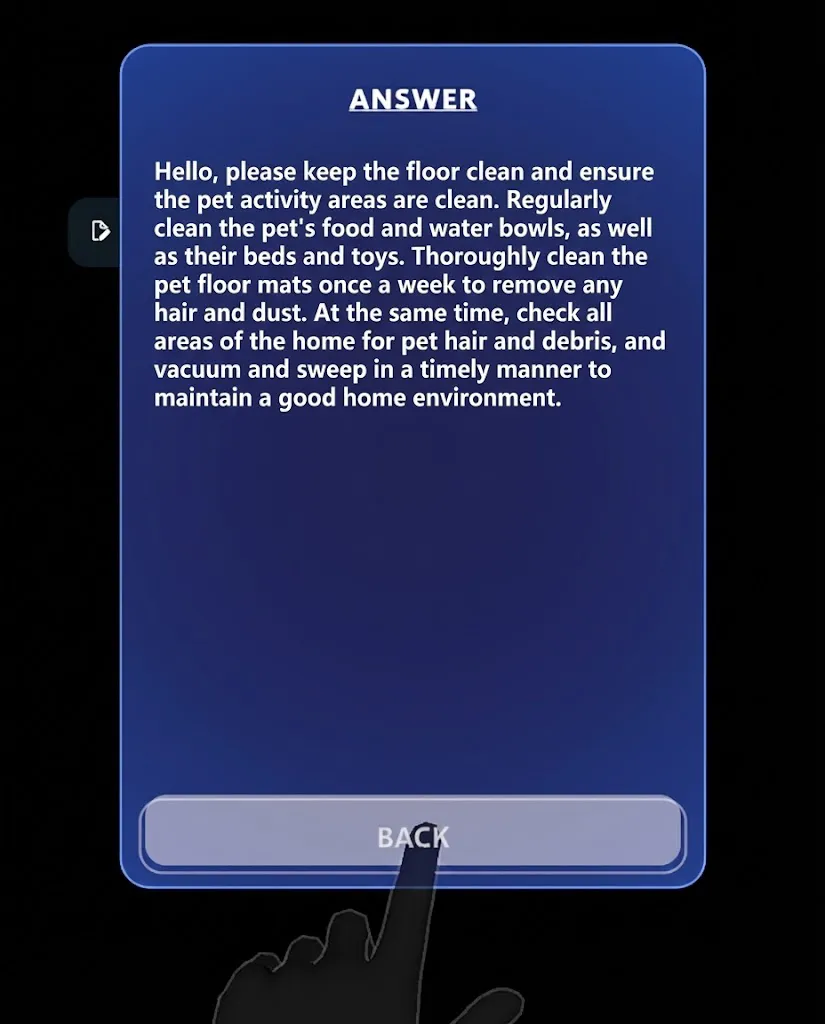
图 9 实验界面,答案对话框
实验界面
任务选择菜单、手指点击提示和 AI 助手对话框构成了被试的主要操作界面。任务里被 AI 助手看到的画面,正是 VisGuardian 要保护的隐私内容。
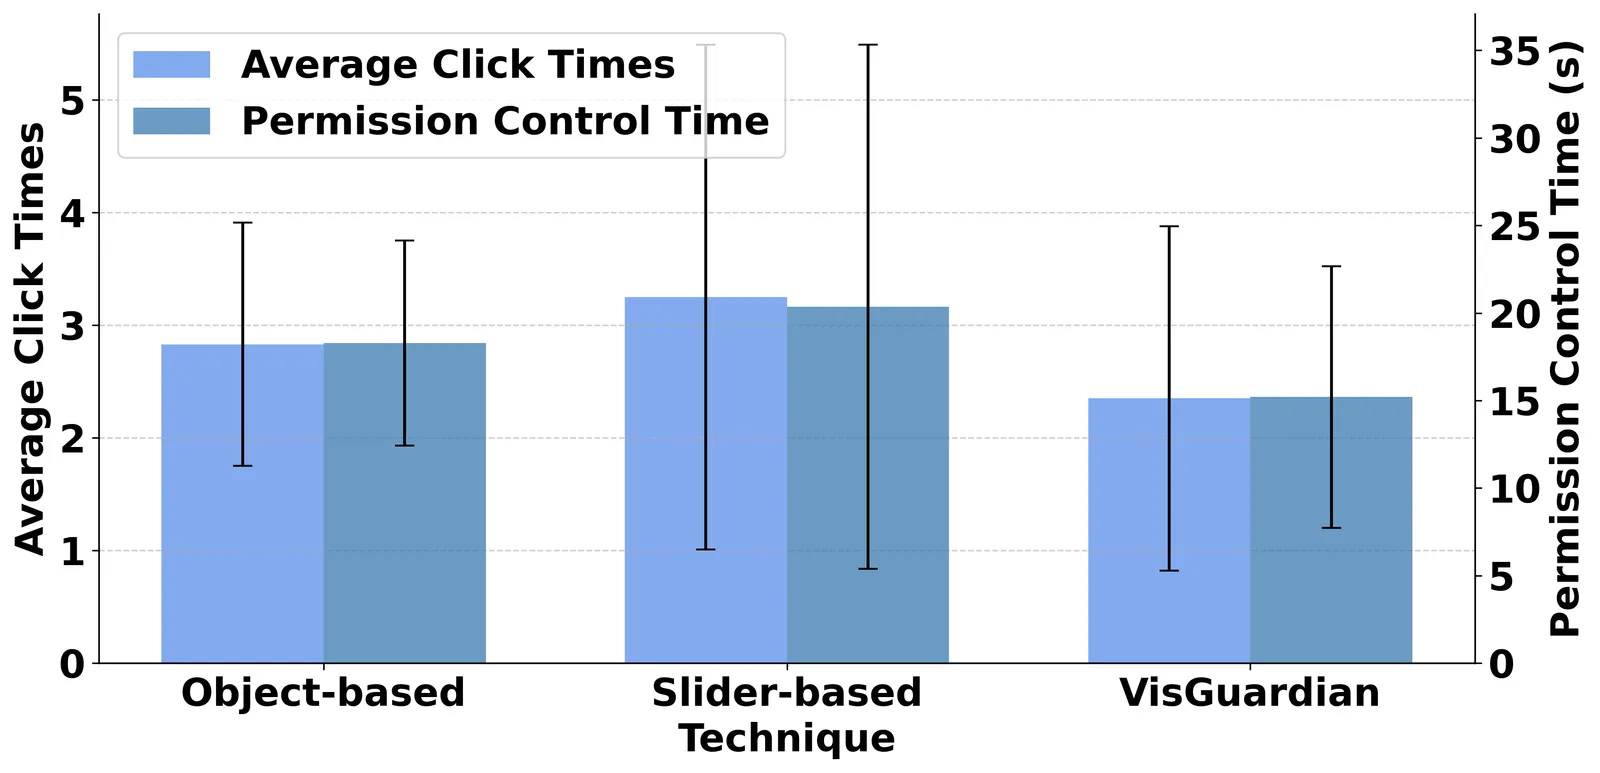
图 10 用户实验结果,点击次数与权限控制时间
效率结果
分组控制确实更快。权限设置时间上,VisGuardian 平均 15.20s,滑块 20.36s,逐物体 18.28s,差异显著(p<0.05);点击次数也更少;每任务总时长 120.6s,同样最短,滑块 141.5s,逐物体 135.9s。分组机制的优势在四类场景里表现一致。
访谈里的用法
访谈里被试表现出三种用法,任务前一次性配好权限;任务中偶尔预览保护状态,确认没有新的泄露;需要时再对个别物体做补充调整。
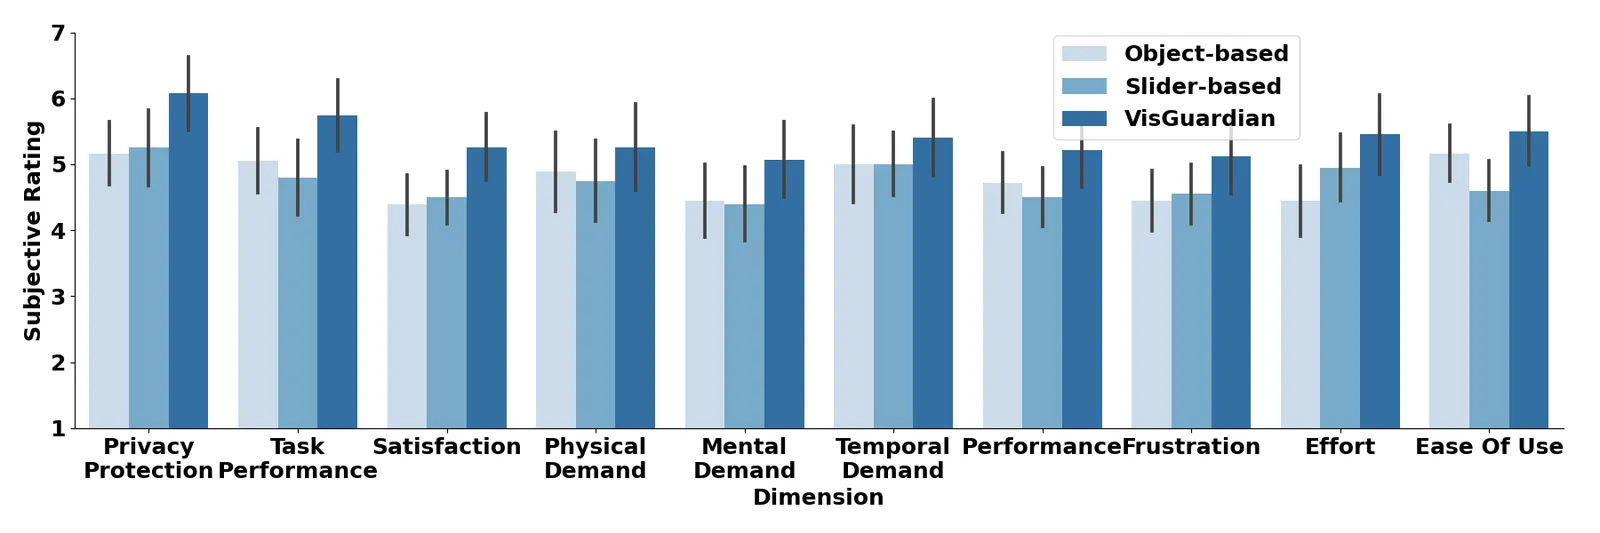
图 11 主观评分结果
主观评分
VisGuardian 在隐私保护、有效性、表现与易用性四个维度上显著优于两种基线,均 p<0.05;满意度、工作量等其他维度与基线没有显著差异。
发表
论文以共同第一作者身份发表于 CHI 2026(ACM SIGCHI,巴塞罗那),全文 22 页。另一项相关工作 SituGuard,用 LLM 做智能眼镜的细粒度隐私控制,以第三作者身份发表于 ACM UbiComp Companion '25,DOI: 10.1145/3714394.3750590。
复盘
分组控制的前提,是分组方式符合用户对隐私的理解。类别、敏感度、位置三个维度覆盖了用户区分隐私物体的主要方式,对照实验也验证了分组控制在设置速度上的优势。
局限同样明确,检测与分组都依赖预置的物体类别。被试在访谈中提出想定义“文档上的文字”,想隐藏能暗示独居状态的物品,系统目前不支持。支持用户自定义敏感物体,是后续要解决的问题。