视频基模评测
从 49 维评测矩阵到 V8 全量榜单,为视频生成模型搭建覆盖 Prompt 构建、VLM 自动评测、人工一致性验证与 ELO 美学排名的完整评测体系。 所有评测工作沉淀在一个可运行的评测平台中,让“模型好不好”有了可量化、可复现的衡量方式。
全文约 4,500 字 阅读约 9 分钟
评测平台把出题、评测、验证、排名与分析串成一条可复现的链路,入口见页首。
图 1 评测平台首页,五大模块入口与全局跑批进度
为什么需要评测
评测与数据、训练并称大模型三大核心工作。视频生成模型训练完成后必须验证效果,“模型生成视频的质量怎么样”看似简单,实则复杂,需要回答三个问题,测什么,定义覆盖指令遵循、物理规律、美学表现的评测维度;怎么测,构建 8 步 Pipeline 自动化生成评测 Prompt 与对应 Checklist;谁来打分,搭建 VLM 自动打分与人工一致性验证的双轨机制。
团队没有现成的视频评测体系,一切从零搭建。评测面临四重难点,维度缺失,视频生成模型的能力维度多而杂,缺乏系统的评测方法;Prompt 构建成本高,人工撰写评测 Prompt 费时费力,难以保证覆盖度;自动打分可信度存疑,VLM 打分是否可靠需要人工验证来回答;美学评测主观性强,VLM 在美学判断上效果不佳,需要回归人工。
我参与了从评测维度定义、Prompt 构建、VLM 跑分到人工验证的各个环节。评测工作需要兼顾算法,知道模型能做什么;产品,知道用户关心什么;设计,知道什么样的画面算好。评测体系无法一次性交付,它随模型迭代持续运转,每一轮版本更新都依赖它给出能力变化的量化信号。
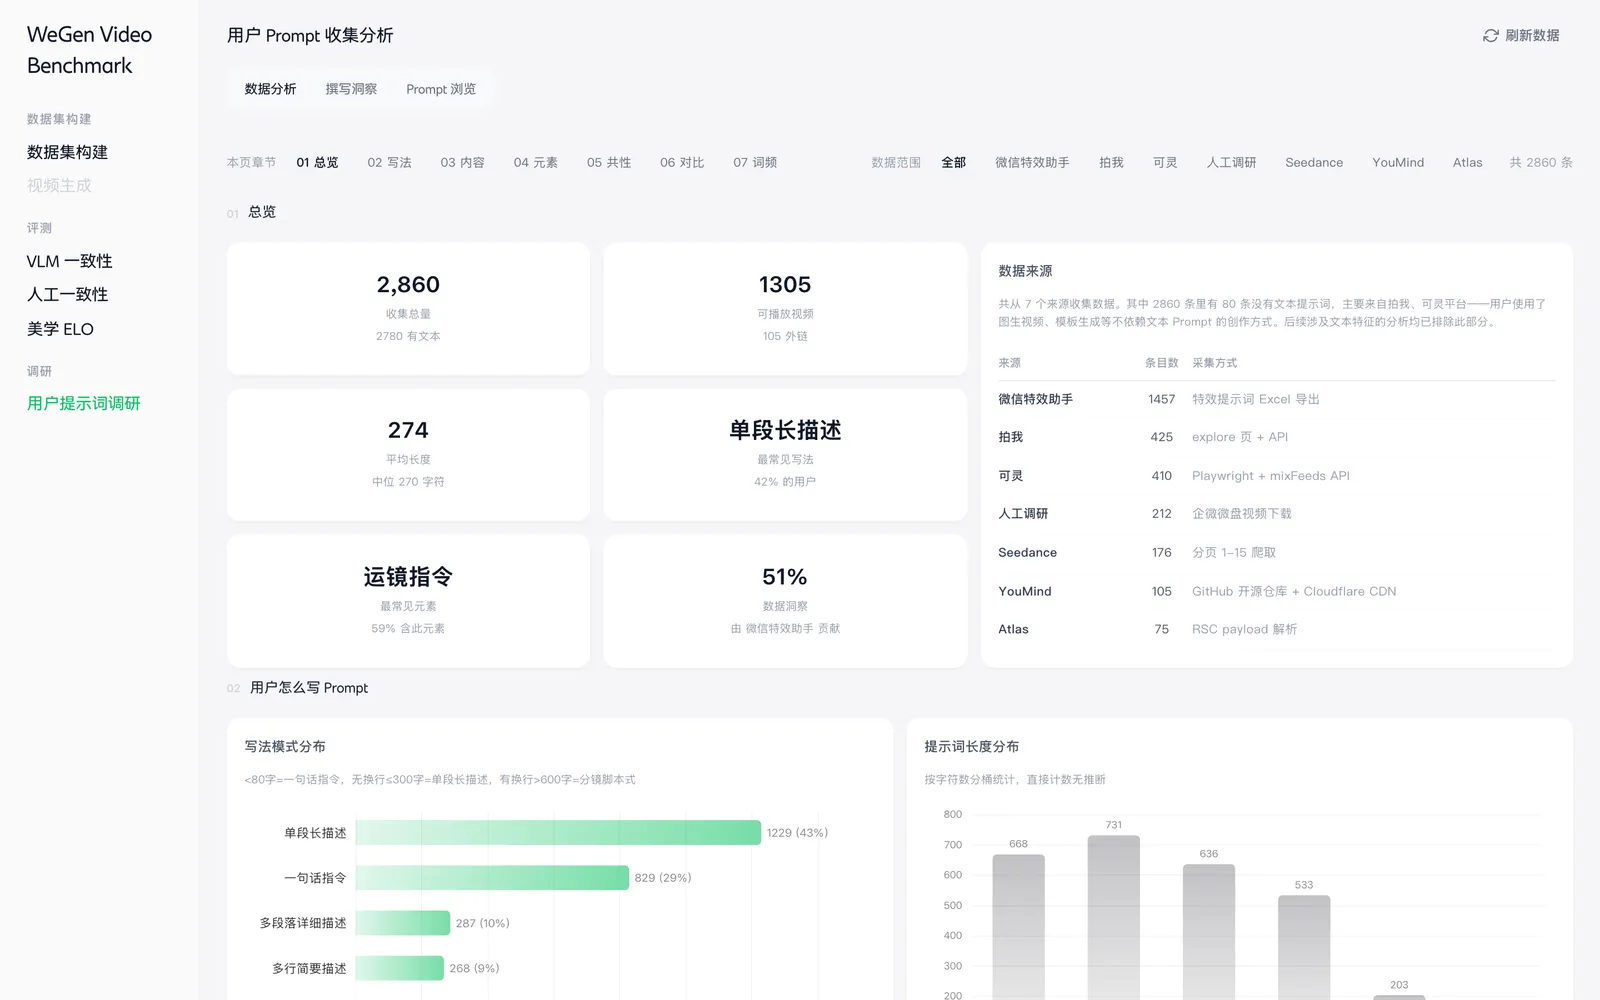
图 2 平台分析看板,评测数据的统计画像
49 维评测矩阵
评测维度决定测什么。矩阵横轴为 10 类主体,纵轴为 27 项能力,按五大能力分组。
| 能力分组 | 覆盖维度 |
|---|---|
| 指令遵循 | 数量精确、颜色绑定、材质属性、空间关系等 |
| 物理规律 | 重力、碰撞、流体、刚体等 |
| 运动表现 | 运动幅度、运动轨迹、运动一致性等 |
| 美学表现 | 构图、色彩、光影、风格等 |
| 人像表现 | 面部表情、肢体动作、口型同步等 |
主体覆盖人像、文字、动物、食物、静物、植物、地标建筑、家居室内、自然风光、交通工具 10 类。维度定义直接决定出题覆盖度,无法靠拍脑袋定版,Prompt 数据集随之经历多轮版本迭代。
维度迭代
| 版本 | Prompt 数 | 特点 |
|---|---|---|
| V6.1 | 343 | 初始版本 |
| V6.2 | 338/448 | 优化维度定义 |
| V6.3 | 462 | 增加场景覆盖 |
| V7.3 | 258 | 细粒度调整 |
| V7.4 | 1031 | 大幅扩展 |
| V8.0 | 1289 | 最终版本 |
每一轮迭代都以上一轮的 VLM 评测结果与人工校验反馈为依据,维度定义不断收敛,Prompt 数量从 343 扩到 1289 条,覆盖度与质量同步提升,最终形成 V8.0 定版数据集。迭代中也有收缩,V7.3 一度收敛到 258 条做细粒度调整,验证维度定义后再放大到 V7.4 的 1031 条,避免带着错误定义批量造题。
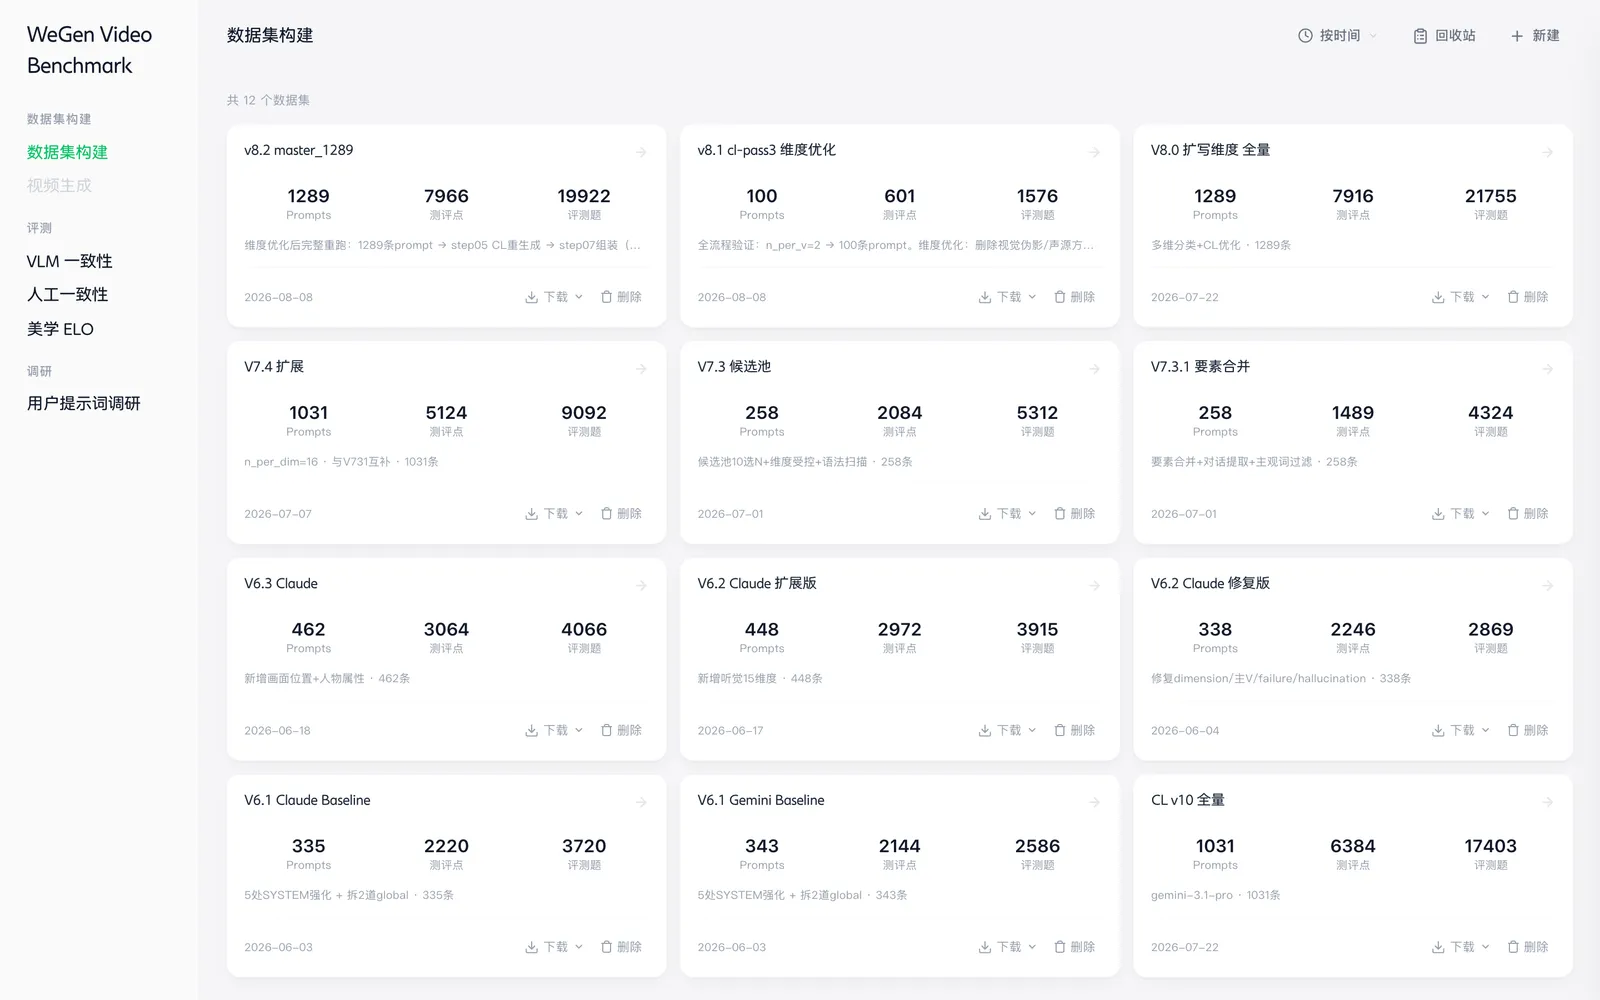
图 3 数据集构建,12 个数据集版本
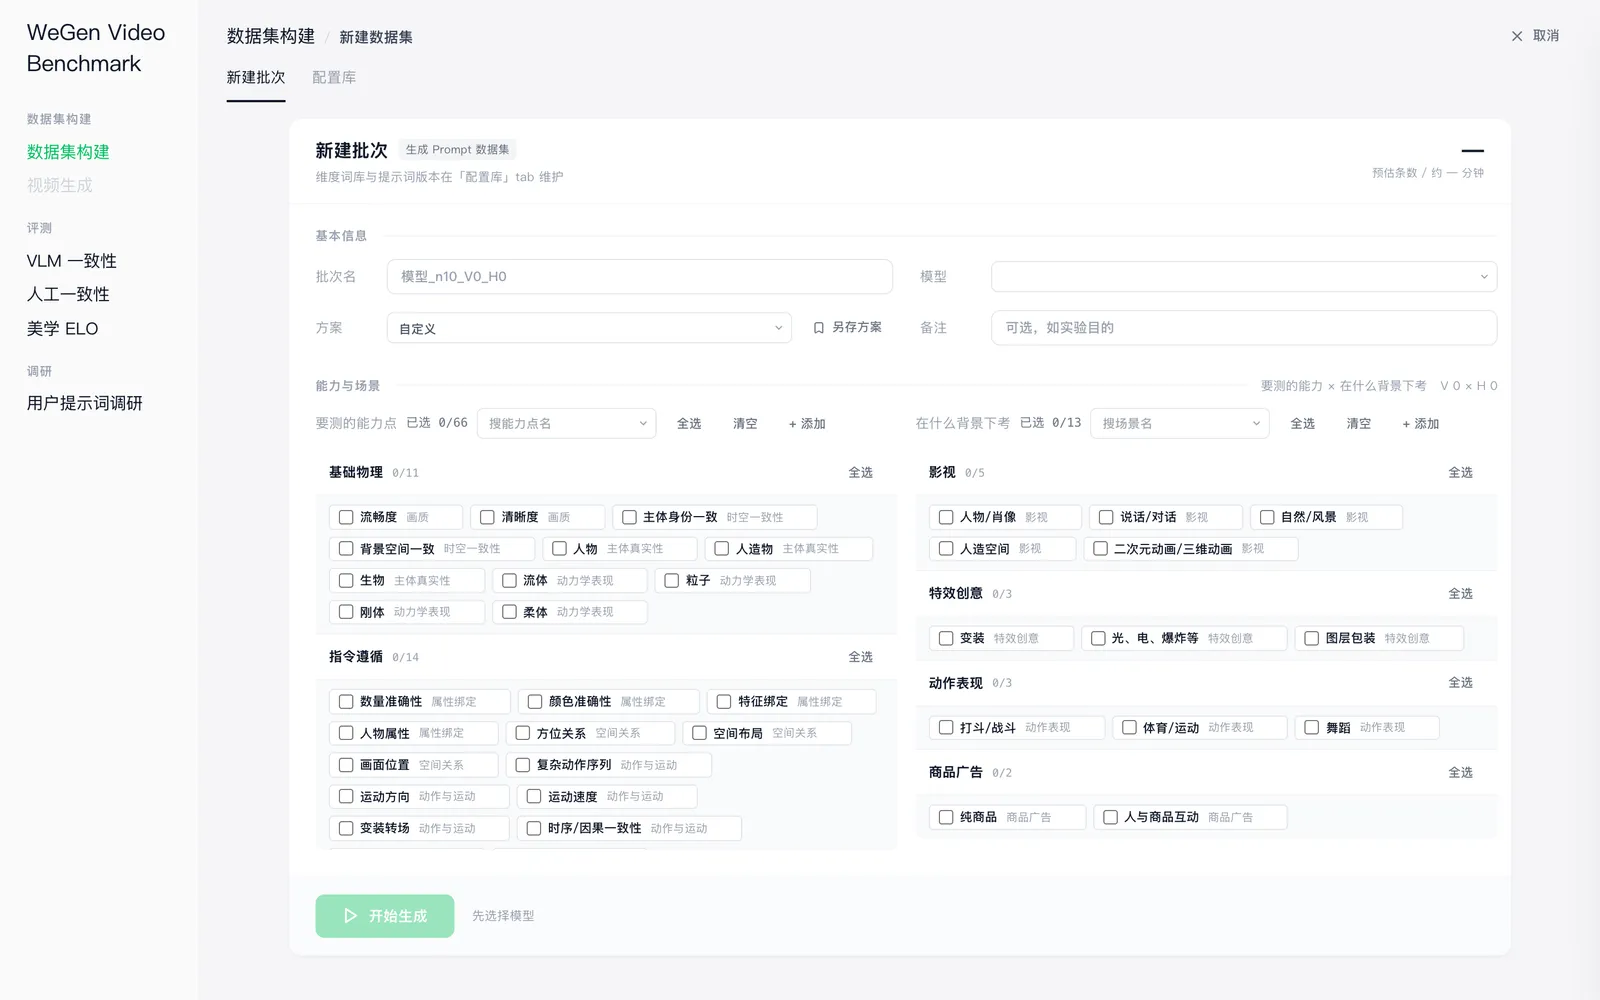
图 4 新建数据集配置页,能力与场景选择、模型与批次配置
8 步 Pipeline 自动化出题
整个 Prompt 构建过程自动化,通过 8 步 Pipeline 从维度定义跑到数据集导出。
Pipeline 的工程要点,任务调度用固定种子保证同维度产出可复现;Prompt 生成以并发 15 路控制节奏;坐标标注纯算法计算关键信息点字符位置,不依赖模型;Checklist 生成内置 8 条禁令与 3 条自检规则,防止题目越界。每个任务在 Step1 生成唯一任务 ID,后续步骤透传该 ID 串起一条 Prompt 的完整生成链路;Step8 导出时按维度分组重新编号为连续整数,供下游视频生成与评测使用。
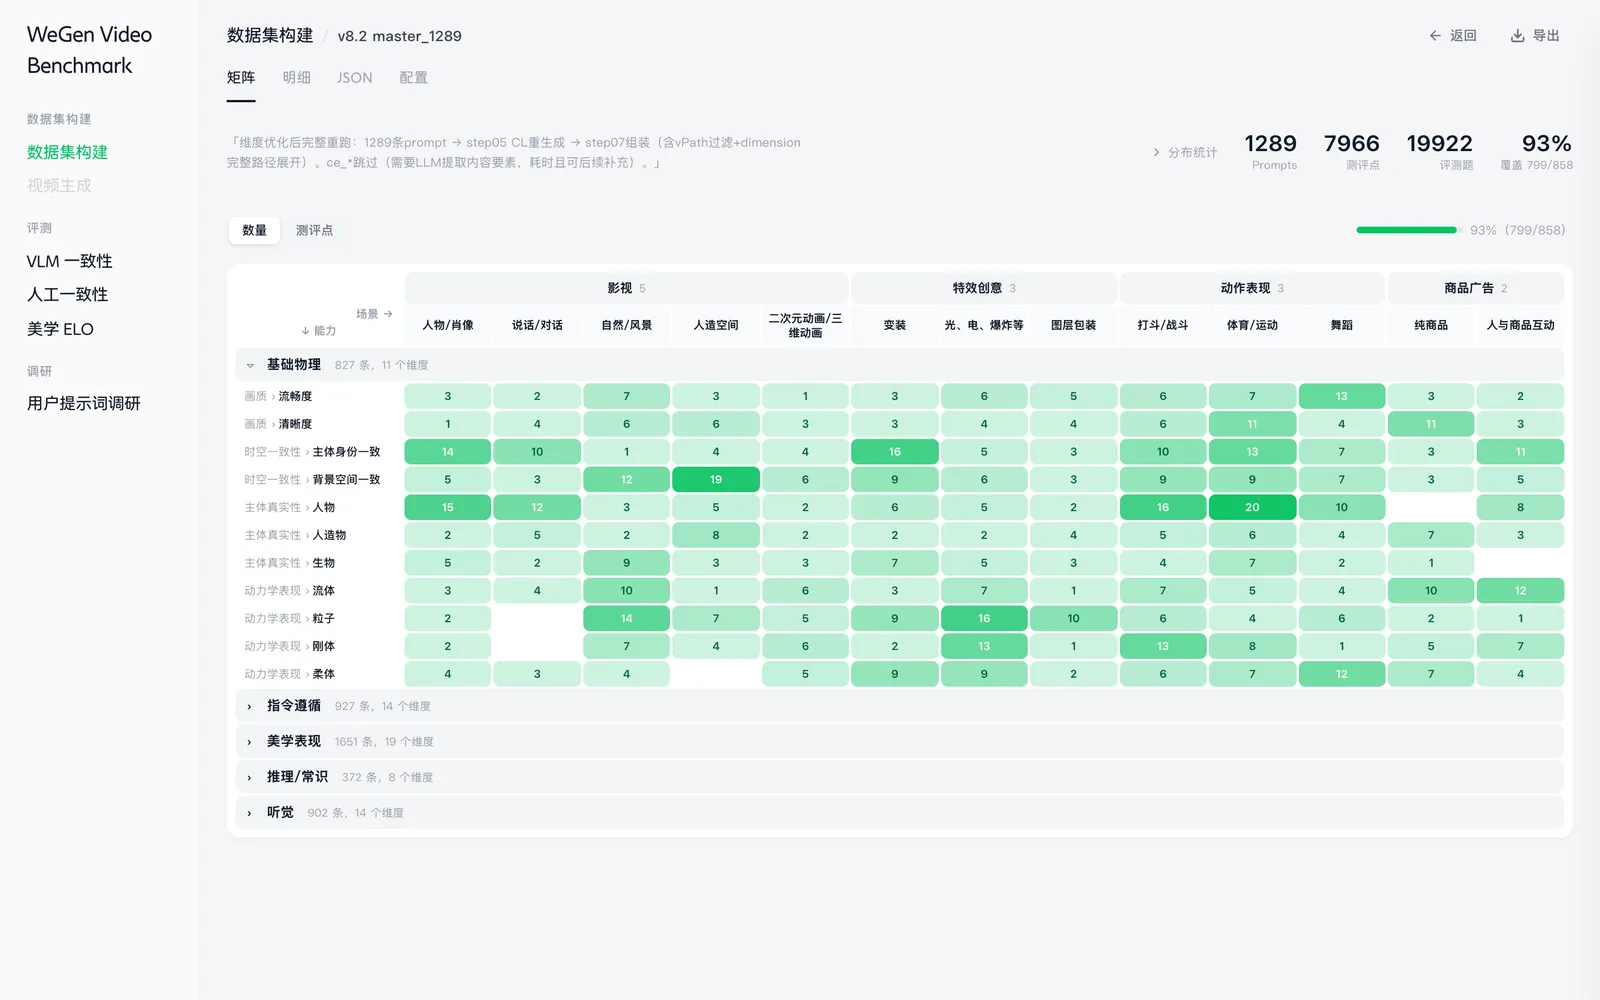
图 5 数据集详情,分布统计与矩阵 / JSON / 配置标签页
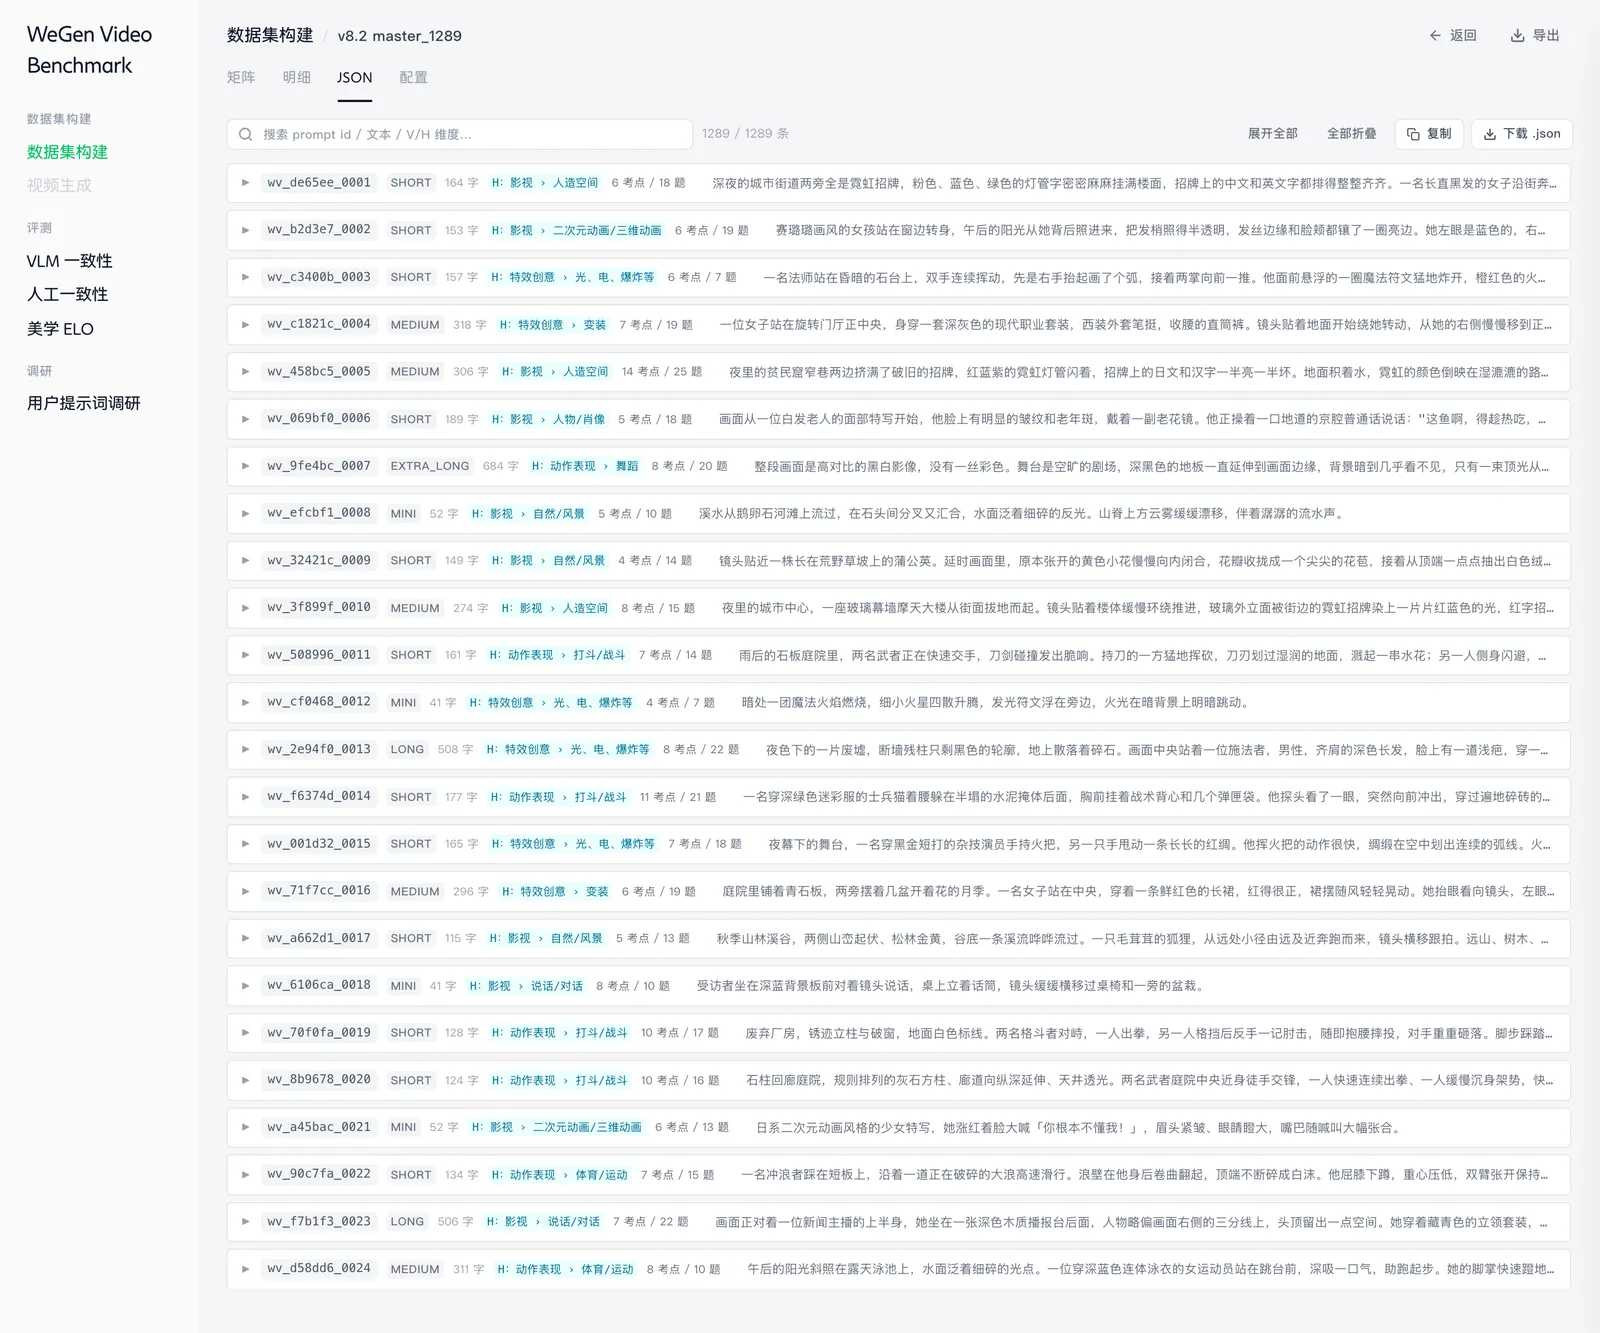
图 6 数据文件结构四件套,Prompt / Checklist / 坐标标注 / 维度标签
产出
最终交付 1289 条评测 Prompt,每条包含 Prompt 文本、Checklist 题目、坐标标注与维度标签四件套。Checklist 题目按内容类型分为三类。
| 类型 | 占比 | 数量 | 说明 | 示例 |
|---|---|---|---|---|
| tpl_ai | 22% | 4335 | AI 感验证 | 人物是否出现非自然扭曲 |
| ce_* | 47% | 9313 | 内容要素核查 | 画面中是否有 5 个杯子 |
| cl_* | 31% | 6274 | 维度能力考核 | 人物动作是否符合描述 |
三类题合计 19922 道,平均每条 Prompt 约 15 道。tpl_ai 验证画面是否符合物理常识,ce_* 核对画面是否忠实于 Prompt 描述,cl_* 考核具体能力维度。坐标标注记录 Prompt 中关键元素的字符位置,供后续视频生成与人工标注精确定位。三类题在评分时也分开统计,tpl_ai 和 ce_* 属于事实判断,cl_* 属于能力判断,两类指标在榜单上分开呈现,互不污染。出题质量是整条评测链的地基,题目问得准,VLM 打分才有意义;题目含糊或越界,再强的模型也答不对。这也是后续实验九把优化重心从调打分 Prompt 转向出题质量的原因。
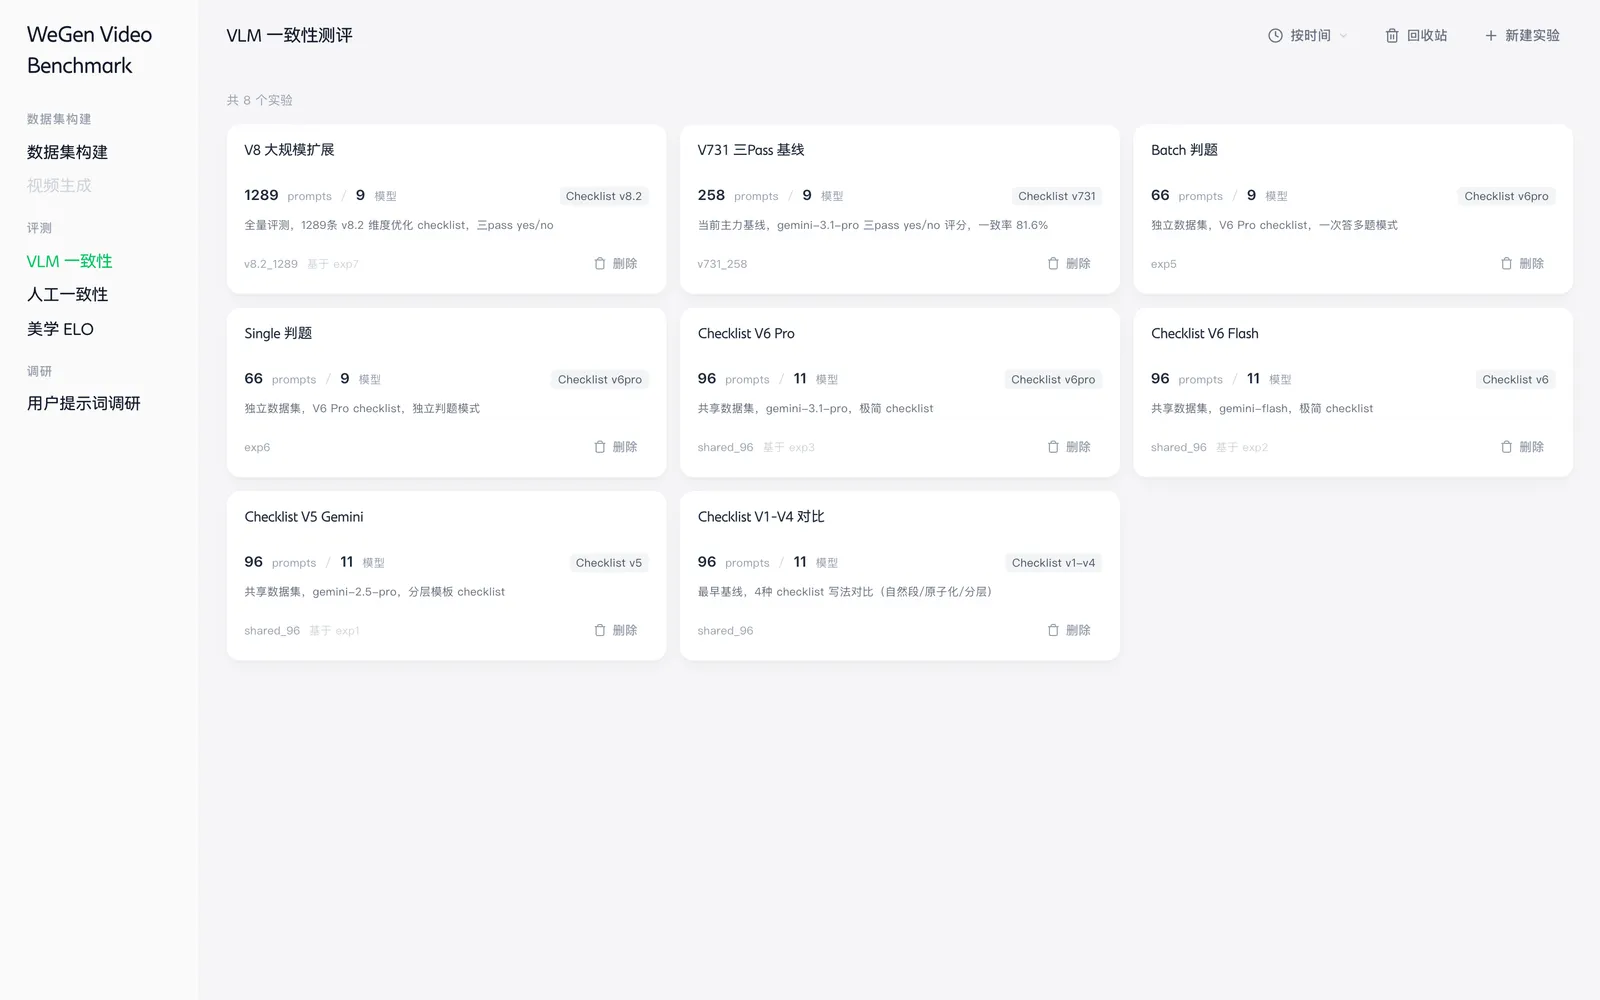
图 7 VLM 一致性评测,8 个实验全景
数据在四个 JSON 文件间流转,结构全程可追溯。
// checklist 题目(exp8_checklist.json,一行一题)
{"qId":"tpl_ai_object","seedId":"wv_0a7cdf_0245","scoring_variant":"v8",
 "question":"物体形貌材质是否稳定清晰?(边界完整性、材质质感、表面形态等)",
 "scoring":"是否","part":"pass1","level":"global","type":"positive",
 "category":"ai_sense","dimension":"指令遵循 > 属性绑定 > 特征绑定"}
// 模型答案(exp8_answers.json,一问一答,含判定理由)
{"seedId":"wv_de65ee_0001","model":"MiniMax-Hailuo-2.3","qId":"tpl_ai_character",
 "answer":"no","reason":"女子回头喊叫时,嘴部张开幅度过大,面部结构出现明显扭曲变形。",
 "part":"pass1","scoring_variant":"v8","judge_mode":"single"}
三 Pass 评测机制
人工逐条打分在视频量级不可行,采用视觉语言模型 VLM 作为自动评分模型,一次生成任务拆成三 Pass 依次判断。
- Pass1 AI 感验证,测试模型是否生成违背物理规律、逻辑常识的内容,人物是否非自然扭曲、物体是否无故消失或出现、空间关系是否合理。
- Pass2 内容要素核查,核对视频内容与 Prompt 描述是否一致,说 5 个杯子画面里是否有 5 个、红色连衣裙颜色是否正确、运动方向是否准确。
- Pass3 维度能力考核,针对具体能力维度考核,材质表现、光影效果、运动轨迹是否达标。
三 Pass 的顺序设计有讲究,先排除画面物理崩坏,再核查内容忠实度,最后进入能力维度的精细打分,层层递进避免误判。分 Pass 而非一次判完,代价是三次调用的成本更高,换来的是某一 Pass 出问题时可以单独定位、单独修复,不必推翻整轮评分。
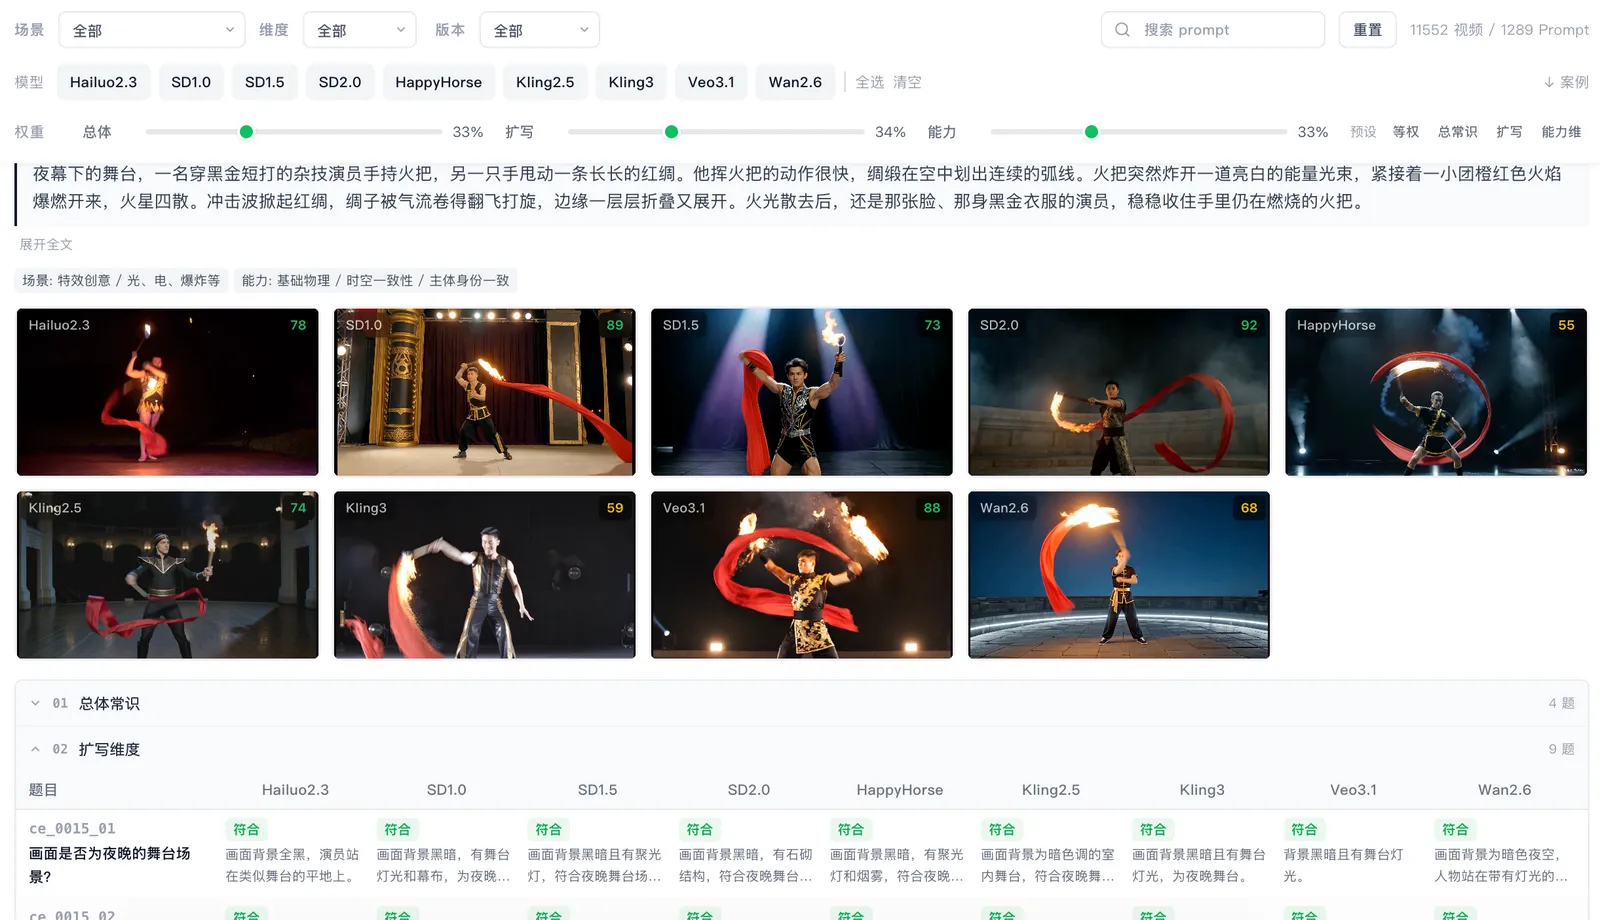
VLM 答题一致性结果质检,逐题一致率与分歧分布
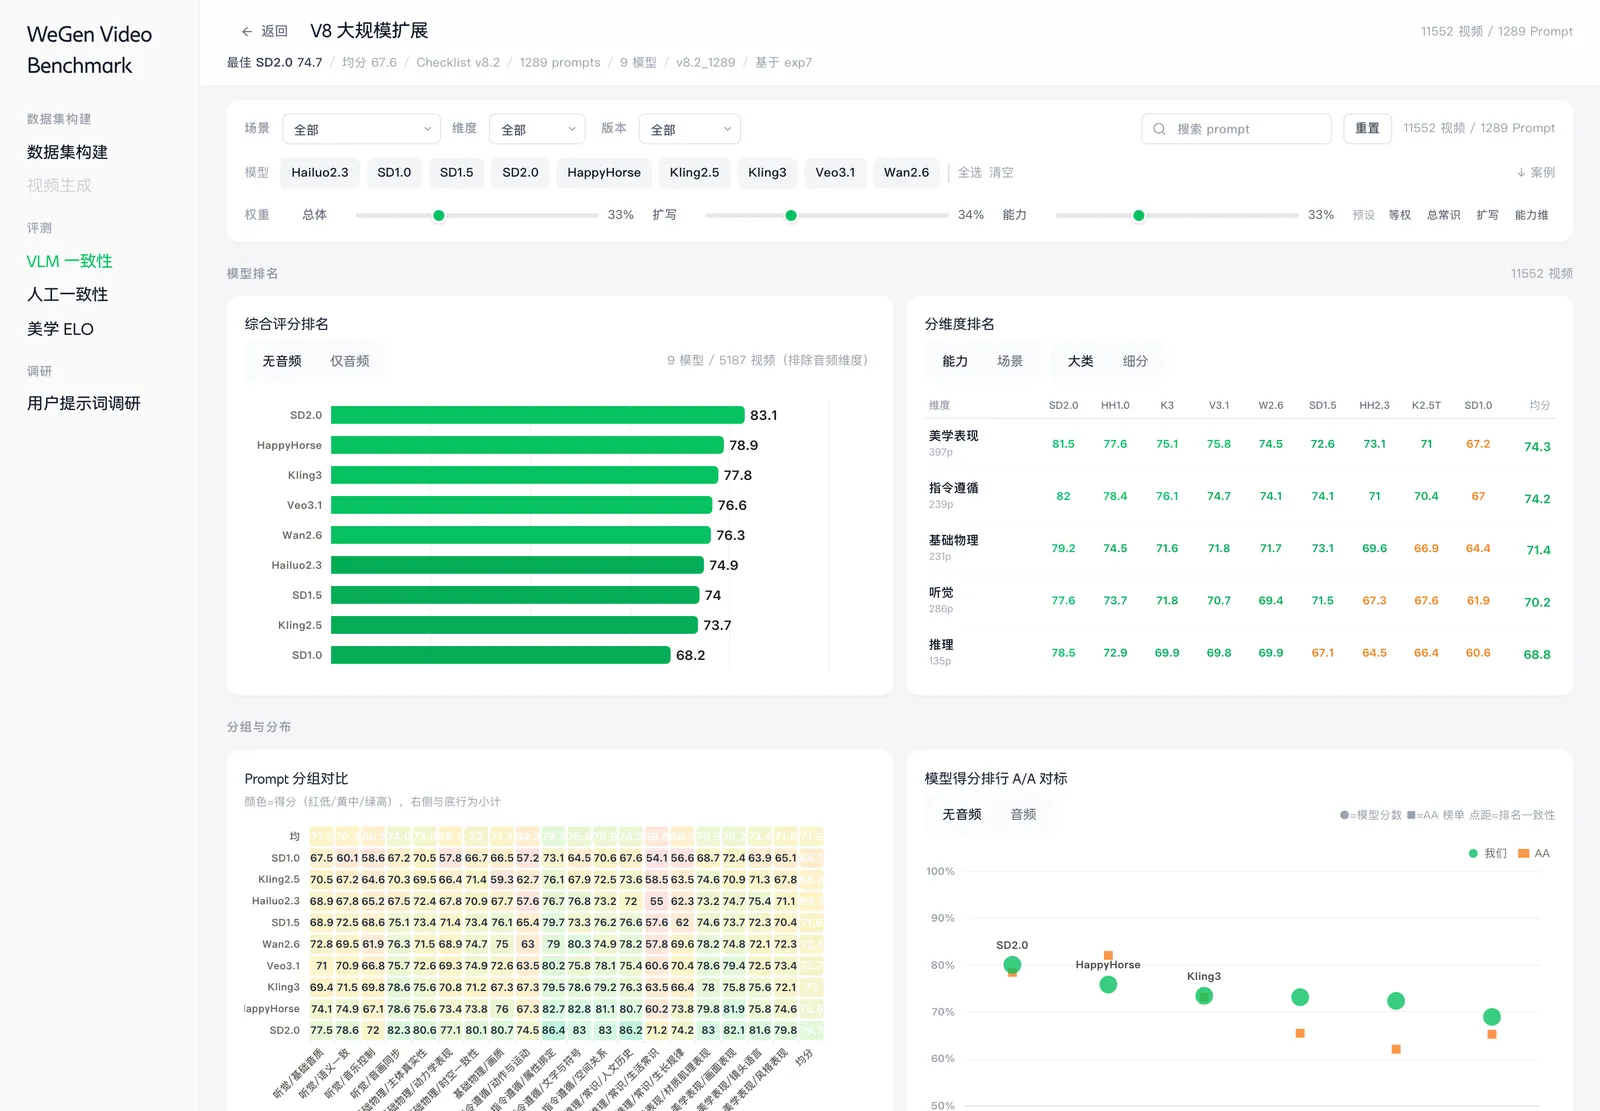
图 8 案例评分矩阵,按模型列展示每个案例的 Pass 判定与分数
评测管线架构
管线分 assemble、evaluate、export 三阶段。evaluate 是最耗时的阶段,以并发 30 路跑批;每条任务完成即落盘,中断后自动跳过已完成部分,断点续传保证长任务可恢复。VLM 调用采用先看帧再判断的观察式 Prompt,输出结构化 JSON,直接进入看板渲染。export 阶段产出四件套数据文件,视频得分、Prompt 维度、Checklist 题目、VLM 答案,前端看板据此渲染 Pass 通过率、模型排名与维度分析等图表。
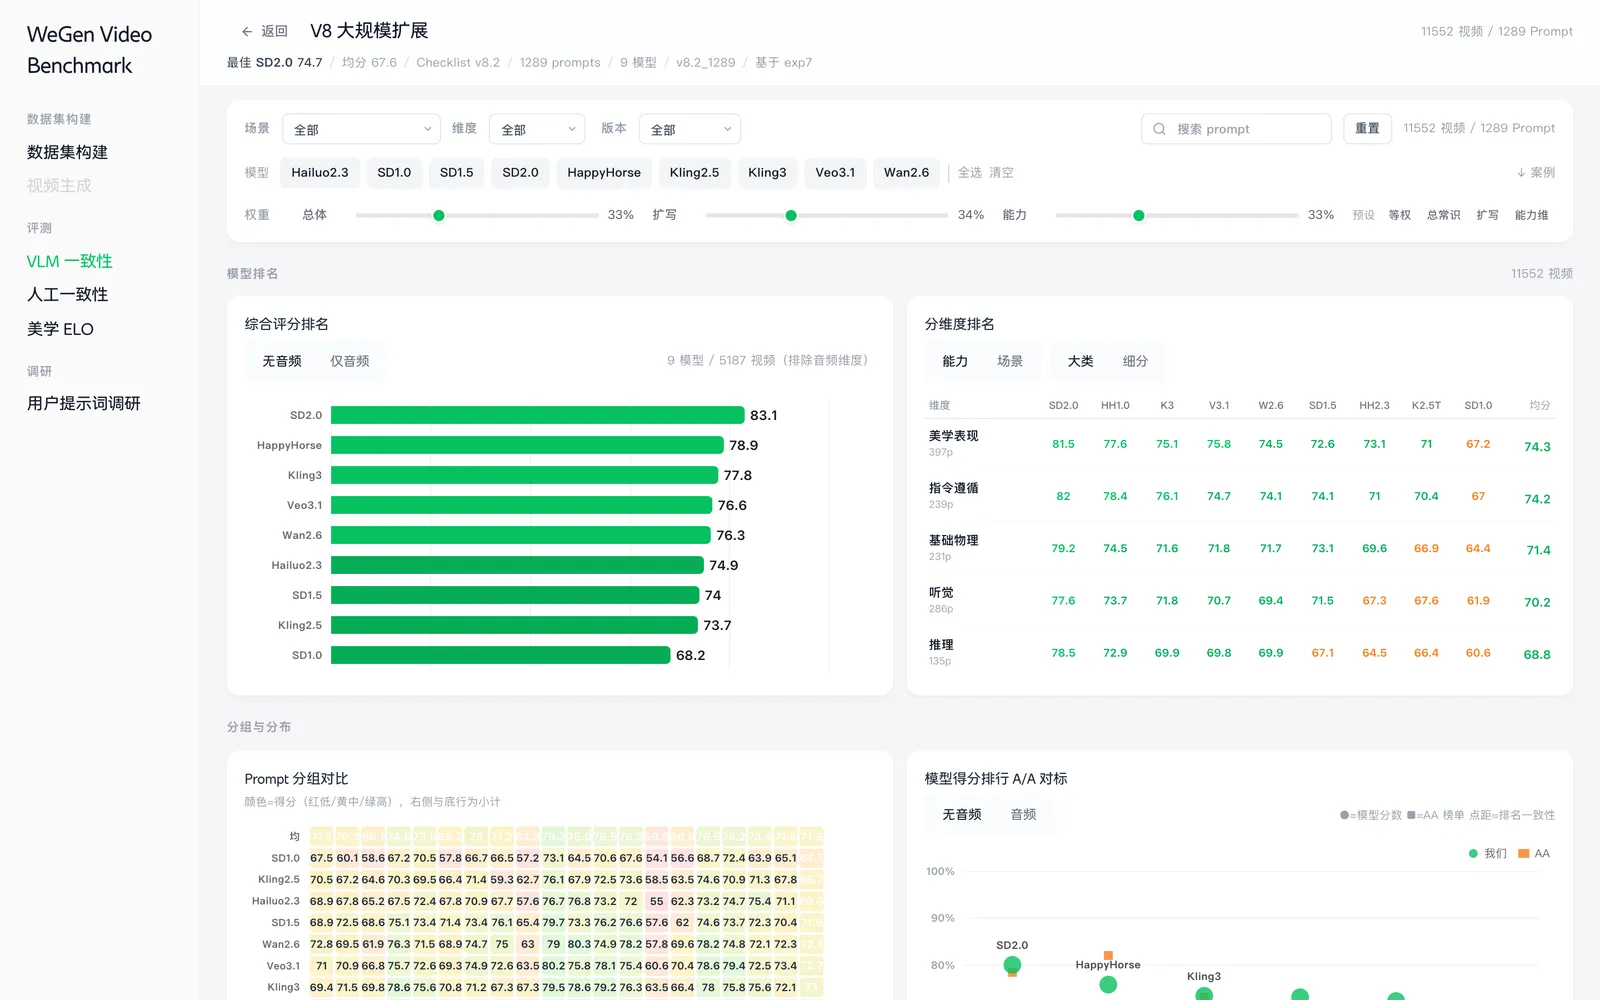
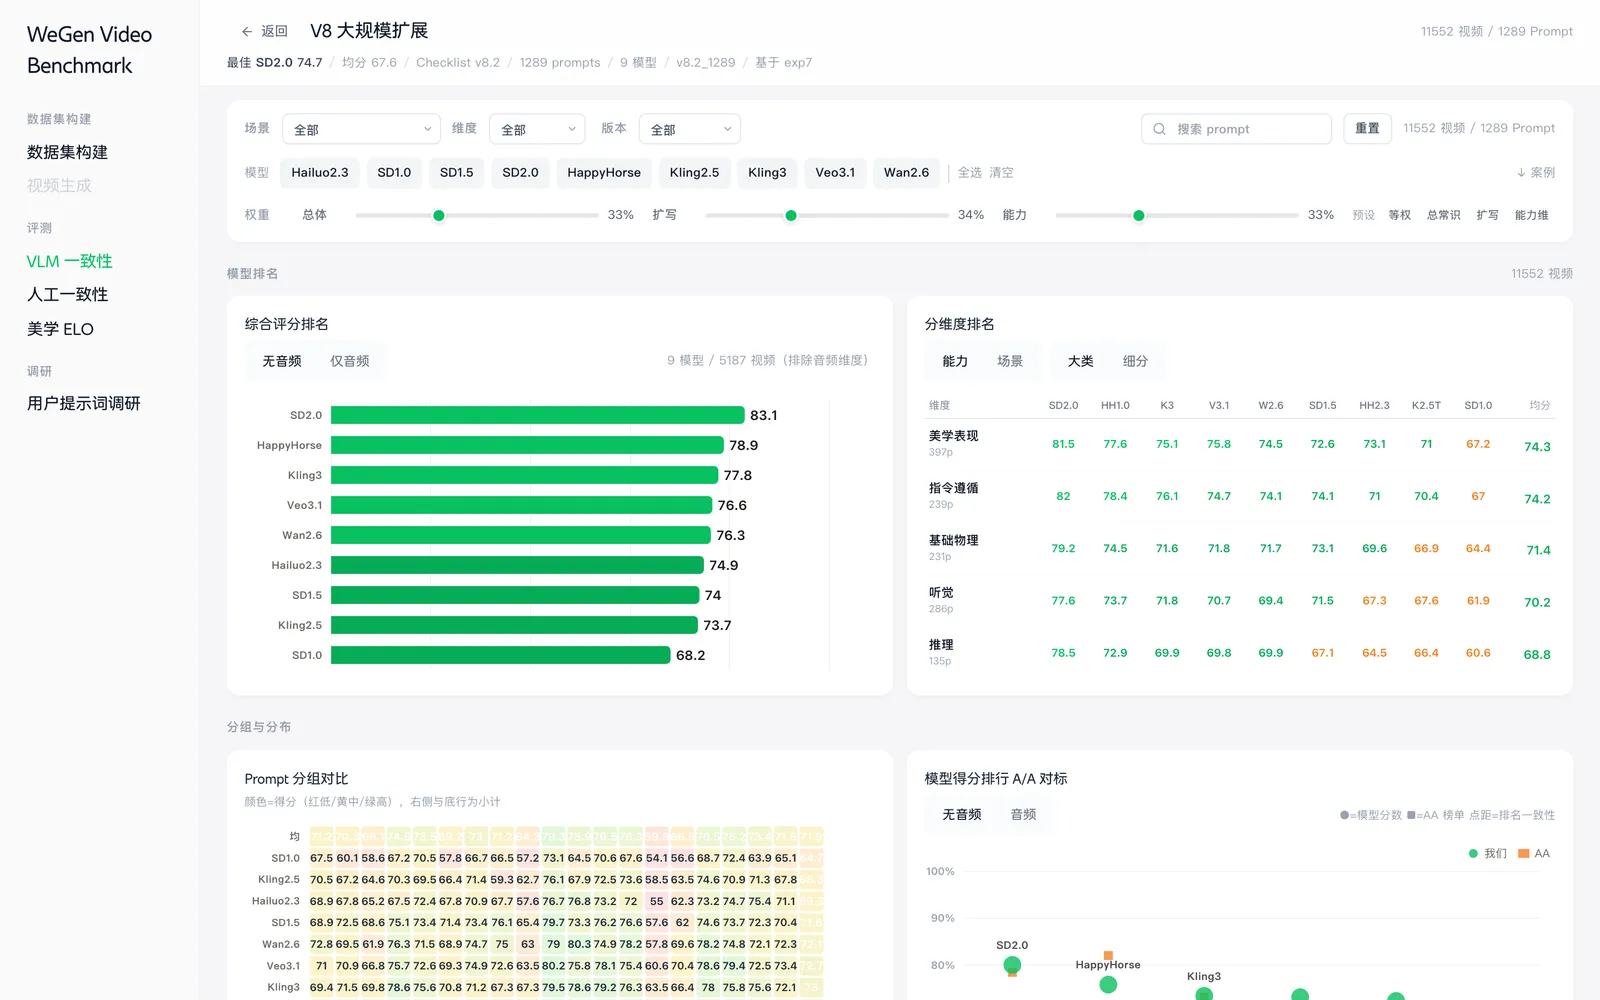
图 9 实验八 V8 大规模扩展详情,meta 与场景筛选
8 轮实验与一致率上限
VLM 评测共经历 8 轮实验迭代,从实验一的 Checklist v1-v4 对比到实验八的大规模扩展与优化验证。实验八聚焦 VLM 打分 Prompt 优化。基线一致率 81.5%,经过三轮逐步深入的验证达到 84.6%。
| 轮次 | 优化内容 | 累计准确率 |
|---|---|---|
| 第一轮 | thinking + observed + 禁止脑补 + 复合约束 | 53.8% |
| 第二轮 | 叠加权重判断,瑕疵占比、视觉重心、持续时间 | 65.4% |
| 第三轮 | 出题优化,瞬时动作转持续特征、前置校验、复合拆分 | 84.6% |
除打分 prompt 外,实验还覆盖 Checklist 版本对比、批量判题与逐题判题对比等方向,逐步验证“怎么问”和“怎么判”两条线。实验九回答 VLM 一致率的天花板问题。基于 5 位标注员 2956 题数据,人类两两一致率 80.9%,6 人理论极限在共识度不低于 80% 的题目上为 91.0%,exp7 实际达到 88.4%。结论,VLM 已发挥 88.4/91.0 即 97% 的理论潜力,剩余差距大部分是模型能力天花板,改打分 Prompt 无法根除,下一步应聚焦出题质量本身。这一结论直接影响了后续版本的数据集改版方向,把瞬时动作改成持续特征、把复合约束拆成原子题,让题目本身先达成人类共识,再交给 VLM。实验体系的另一个作用是沉淀方法,每轮实验的配置与结论都记录在案,后续新实验可以直接继承前一轮的 Checklist 与打分模型,不必从零开始。
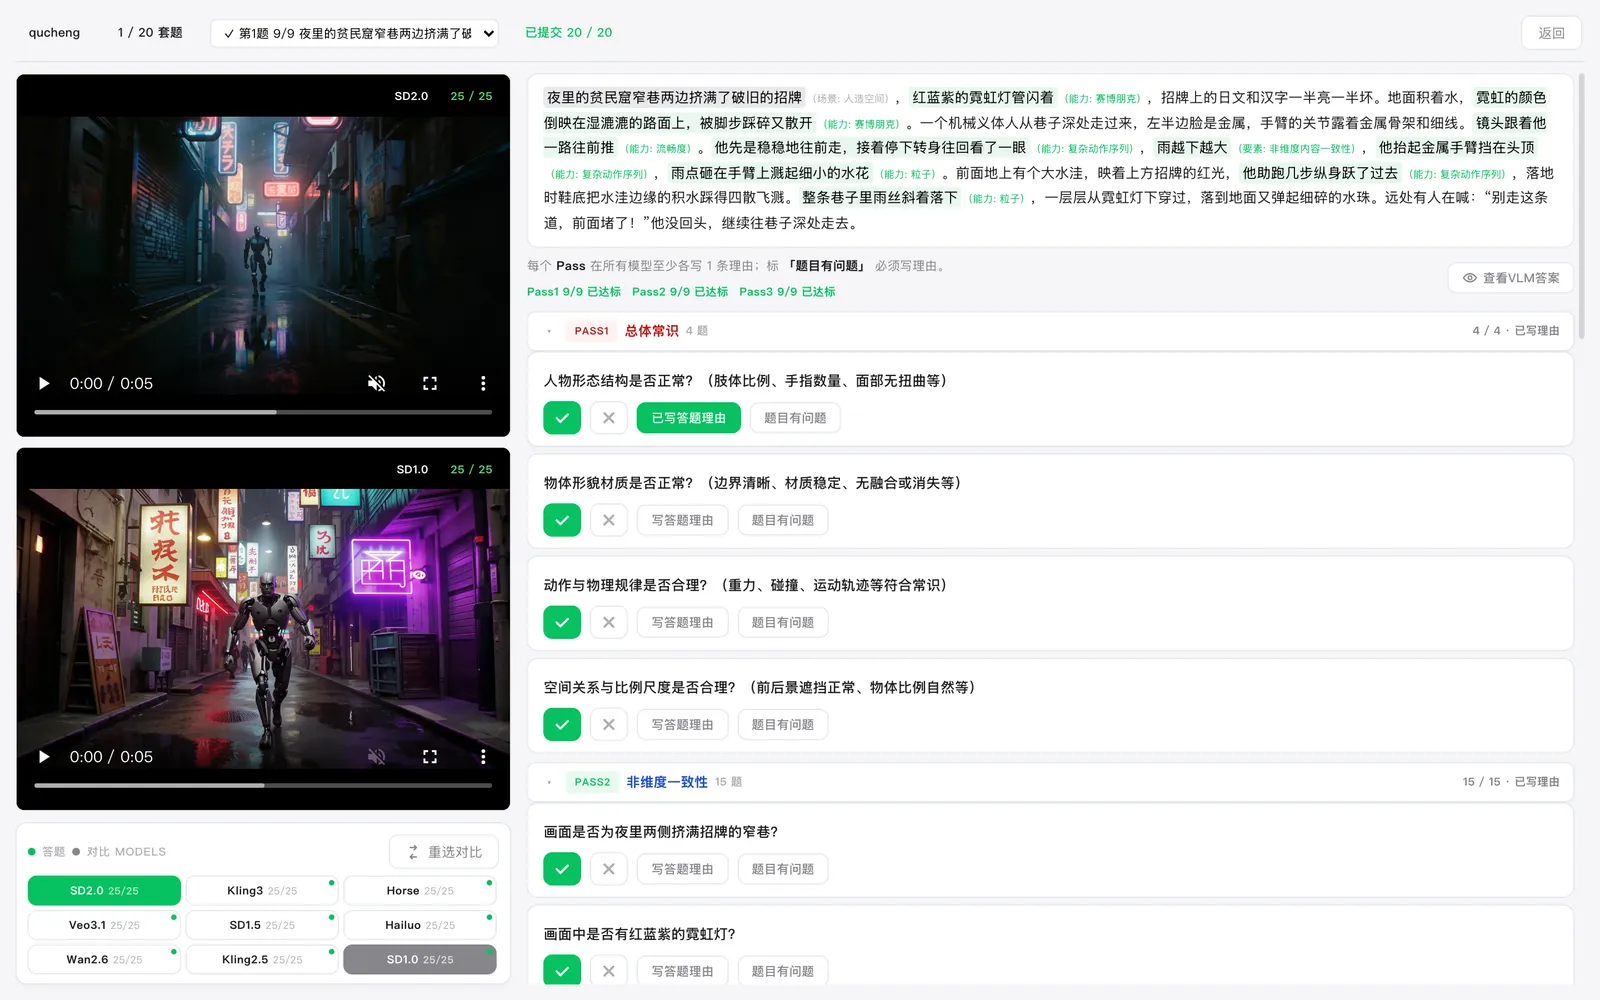
图 10 人工一致性标注,标注员单题判定界面,视频与题目并排,Yes / No 二选一
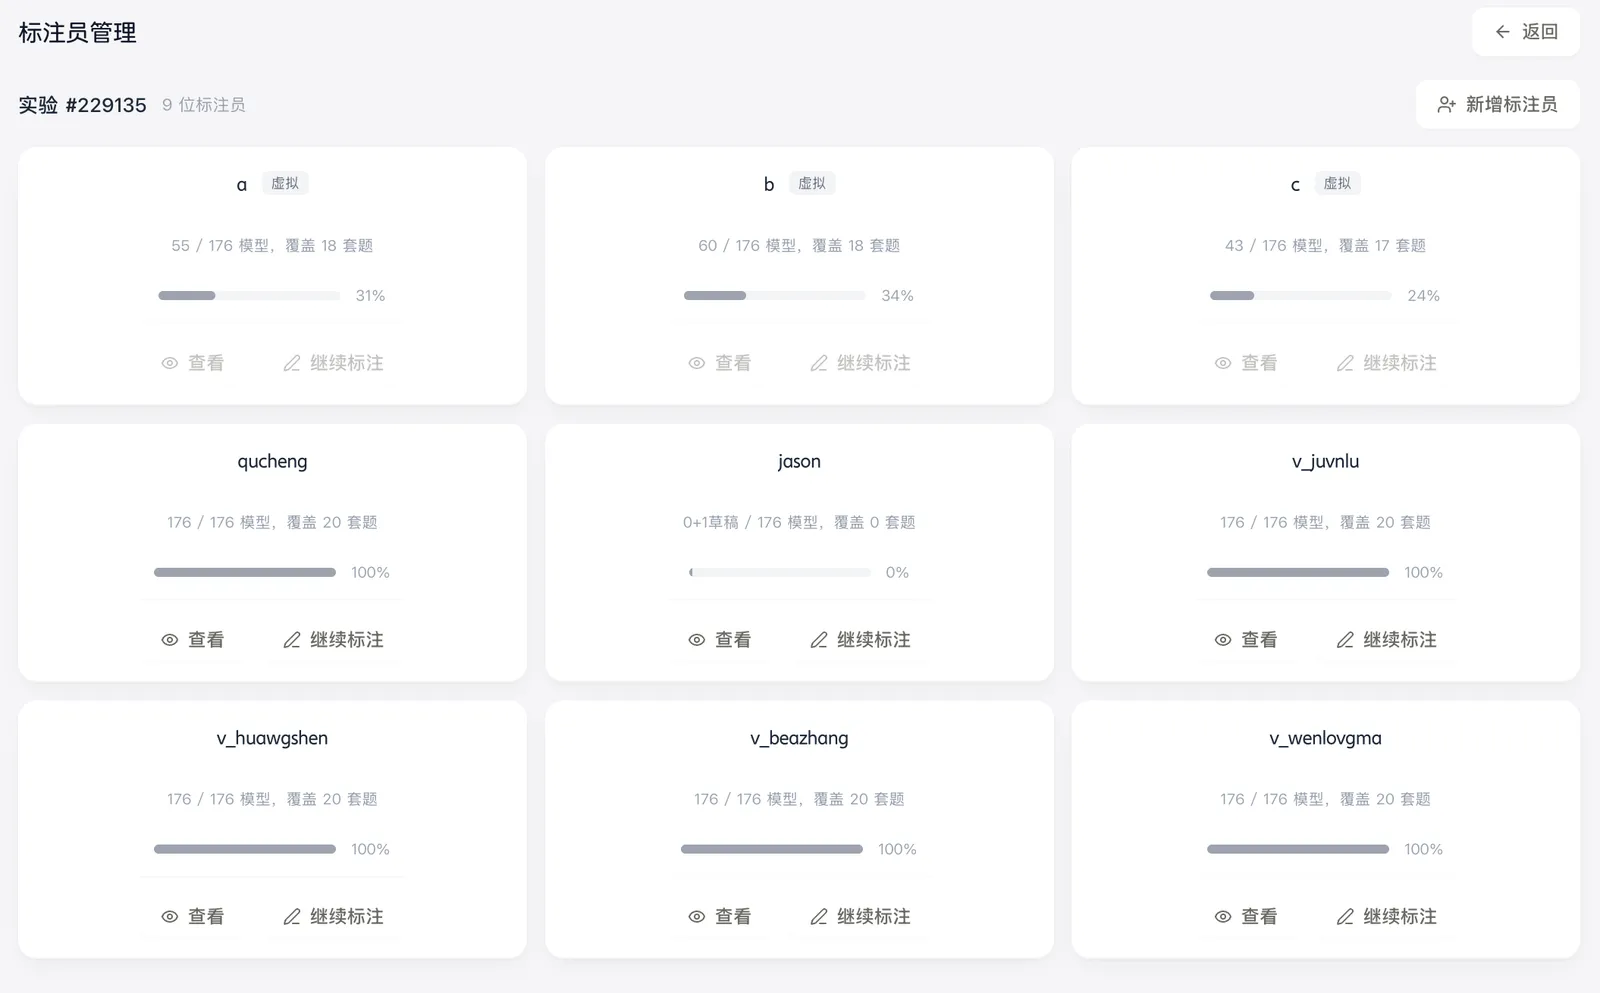
标注员标注页面,题目、视频与判定区域
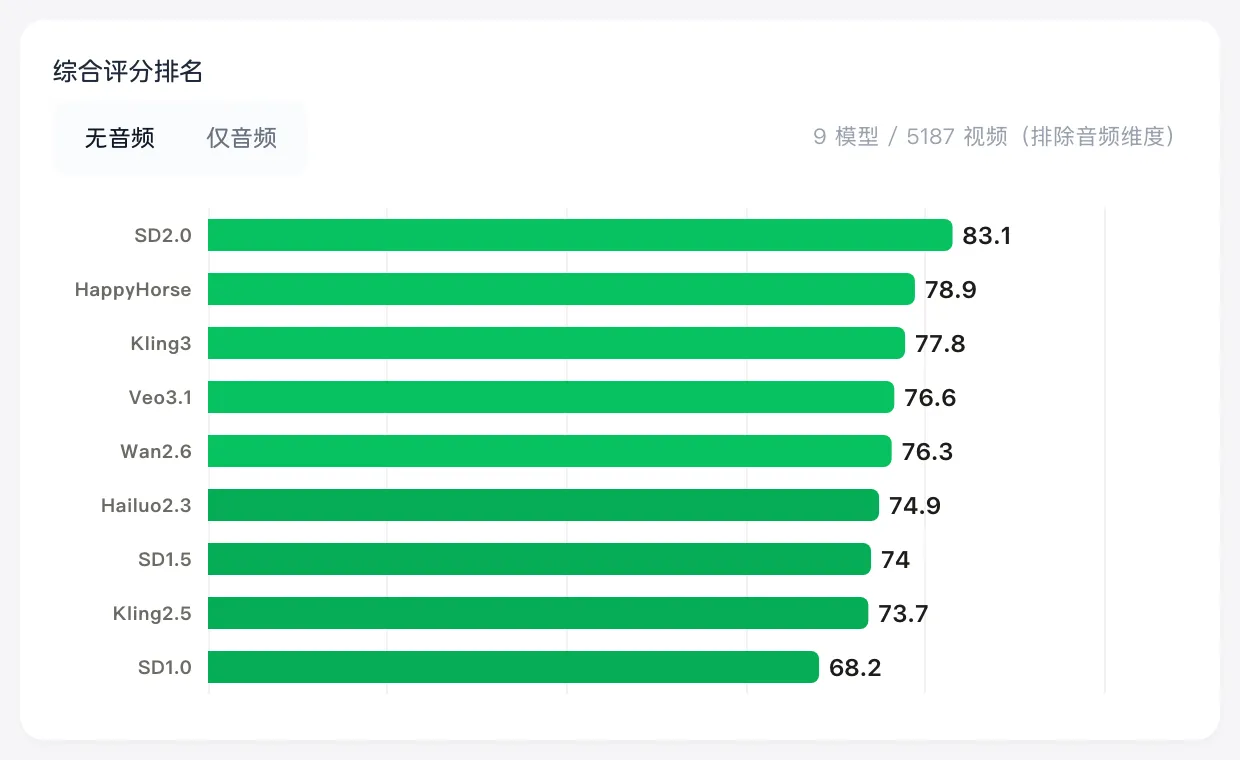
模型排名与稳定性
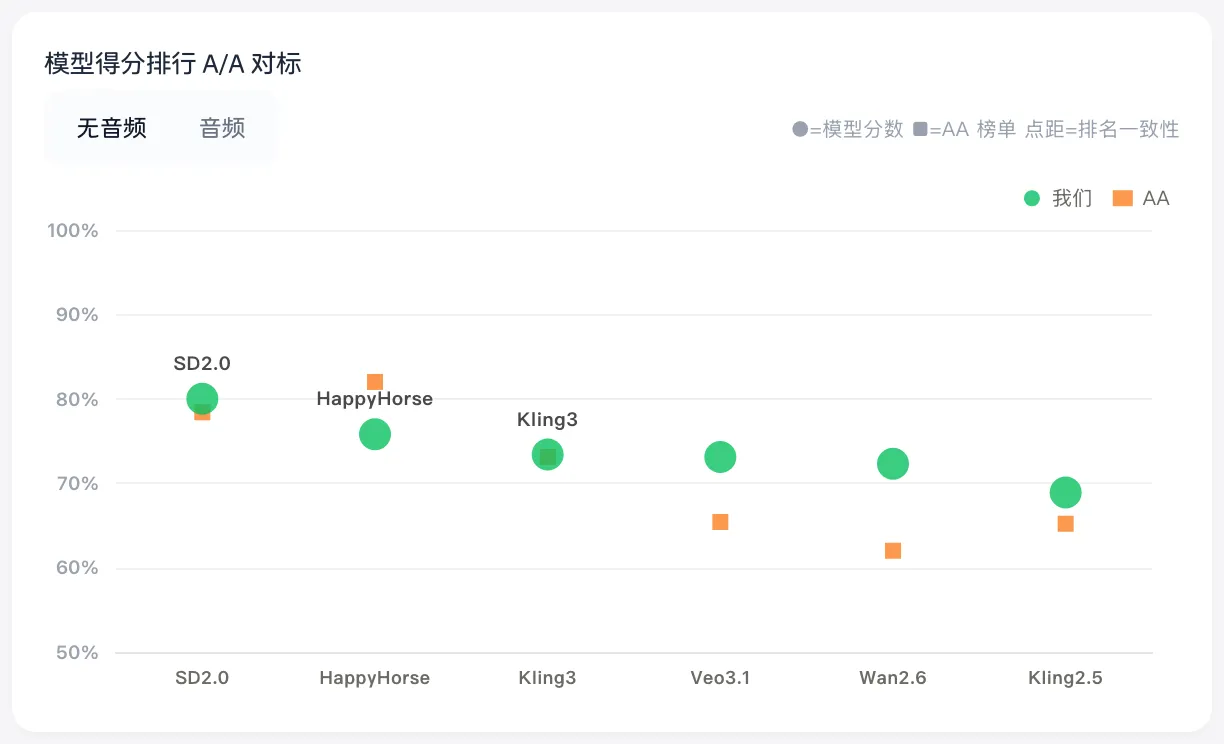
与 AA Benchmark 的散点对照
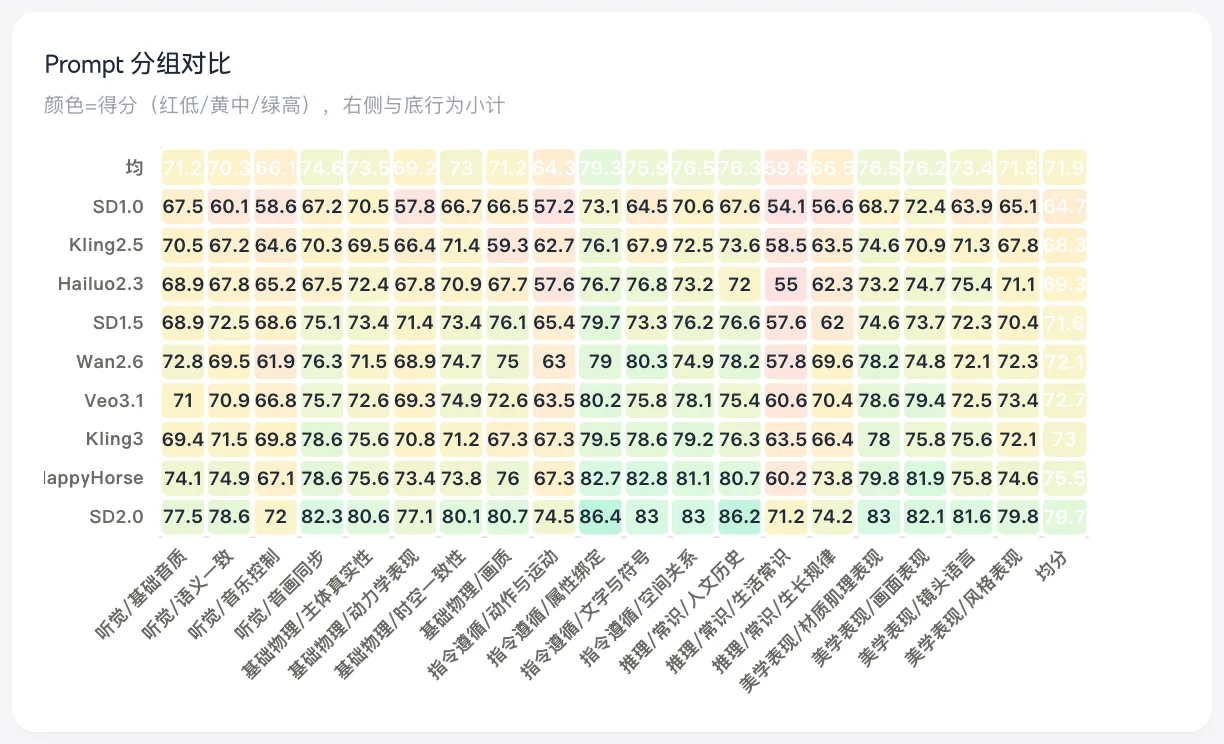
各组实验排名对比
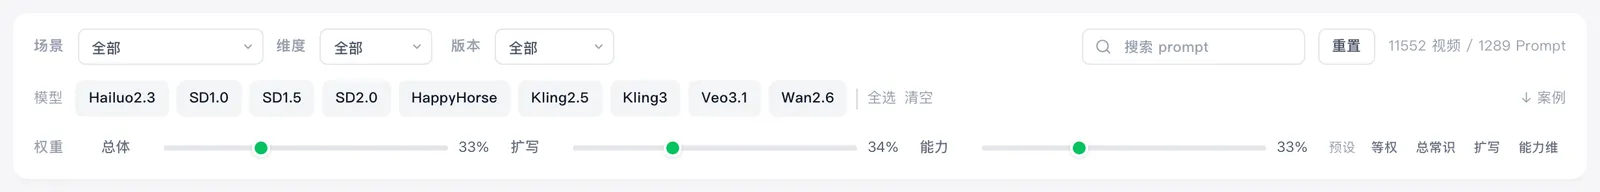
各维度权重占比
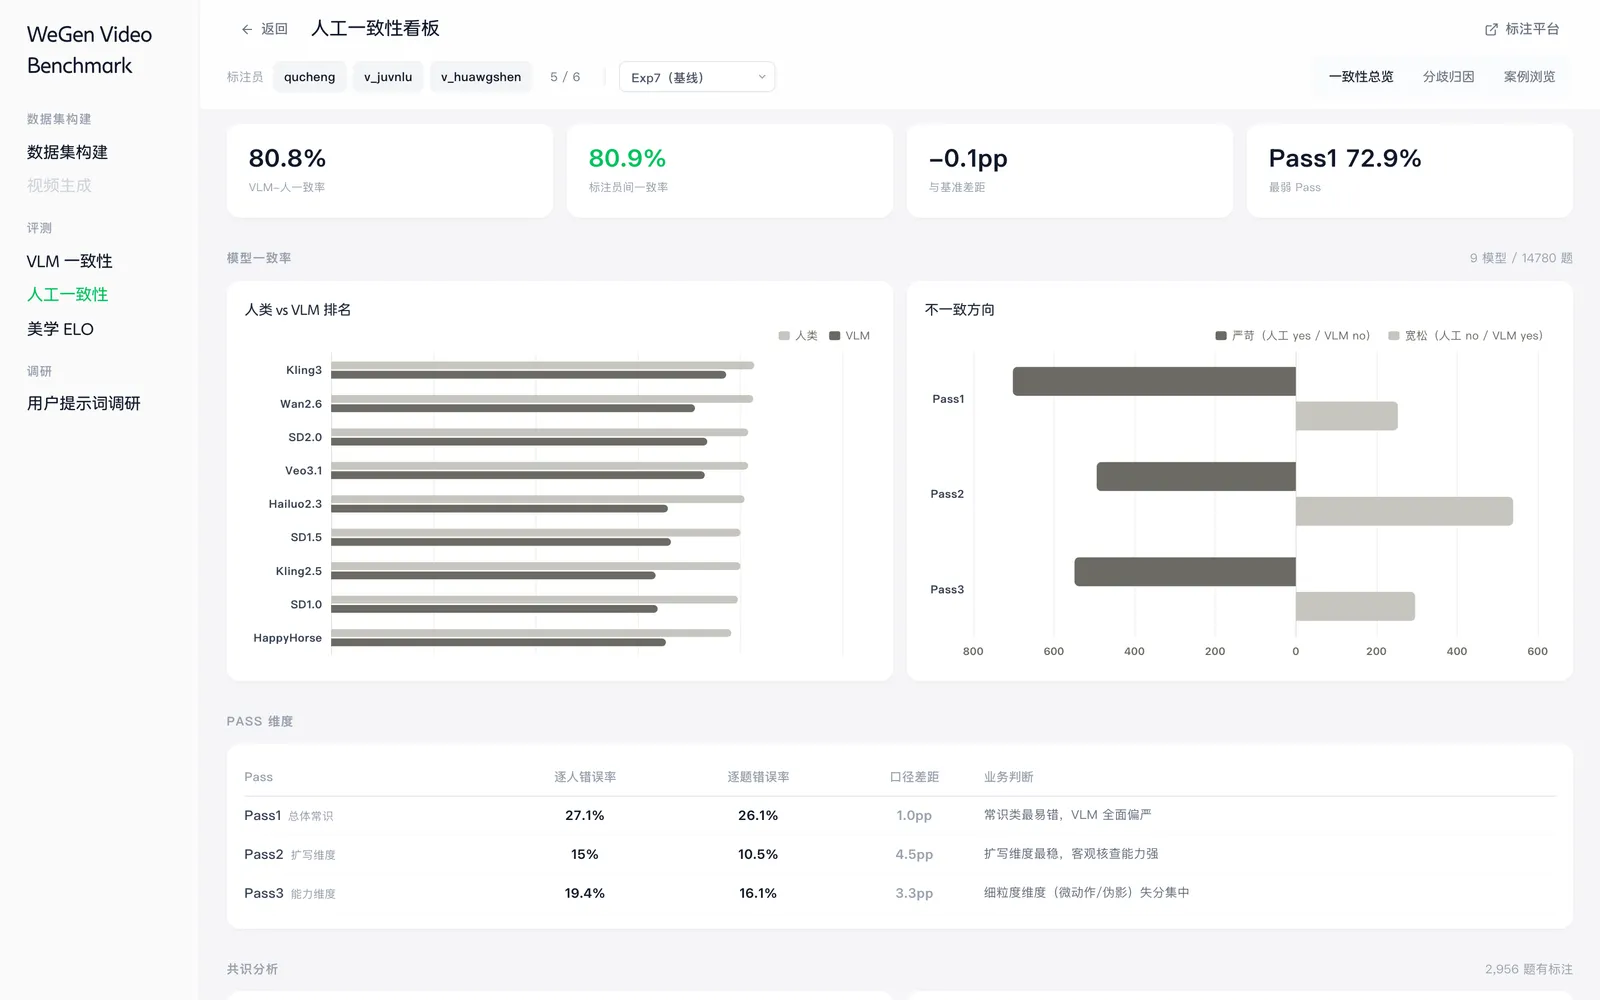
图 11 人工一致性看板,一致率、模型排名与 Pass 分析
实验设计与关键发现
VLM 打分再高,与人的判断不一致就没有意义。人工验证要回答,VLM 打分可信吗,哪些维度打得好,哪些打得差。实验设计,5 位标注员从 V7.3.1 的 258 条 Prompt 中随机抽取 20 组,对 9 个模型生成的视频独立完成 Checklist 标注,合计 2956 题。
关键发现。
- 总体一致率 80%+,可接受,VLM 基本可用;
- Pass2 内容要素核查 85%,表现良好,无需调整;
- Pass1 AI 感验证约 75%,偏严,VLM 倾向于主动找茬。
人工验证的样本量与模型数挂钩,9 个模型都要覆盖,最终 2956 道题每道都有 5 份人类答案,可以计算任意两人之间的一致率。样本从 258 条 Prompt 中分层抽取,保证覆盖不同主体类别与难度梯度;标注平台只保留题目与视频,剥离一切干扰,标注员只需二选一,培训成本低。每位标注员独立标注,不相互讨论,保证答案反映真实个体判断;标注完成后汇总为对照矩阵,作为 VLM 一致率的基准。
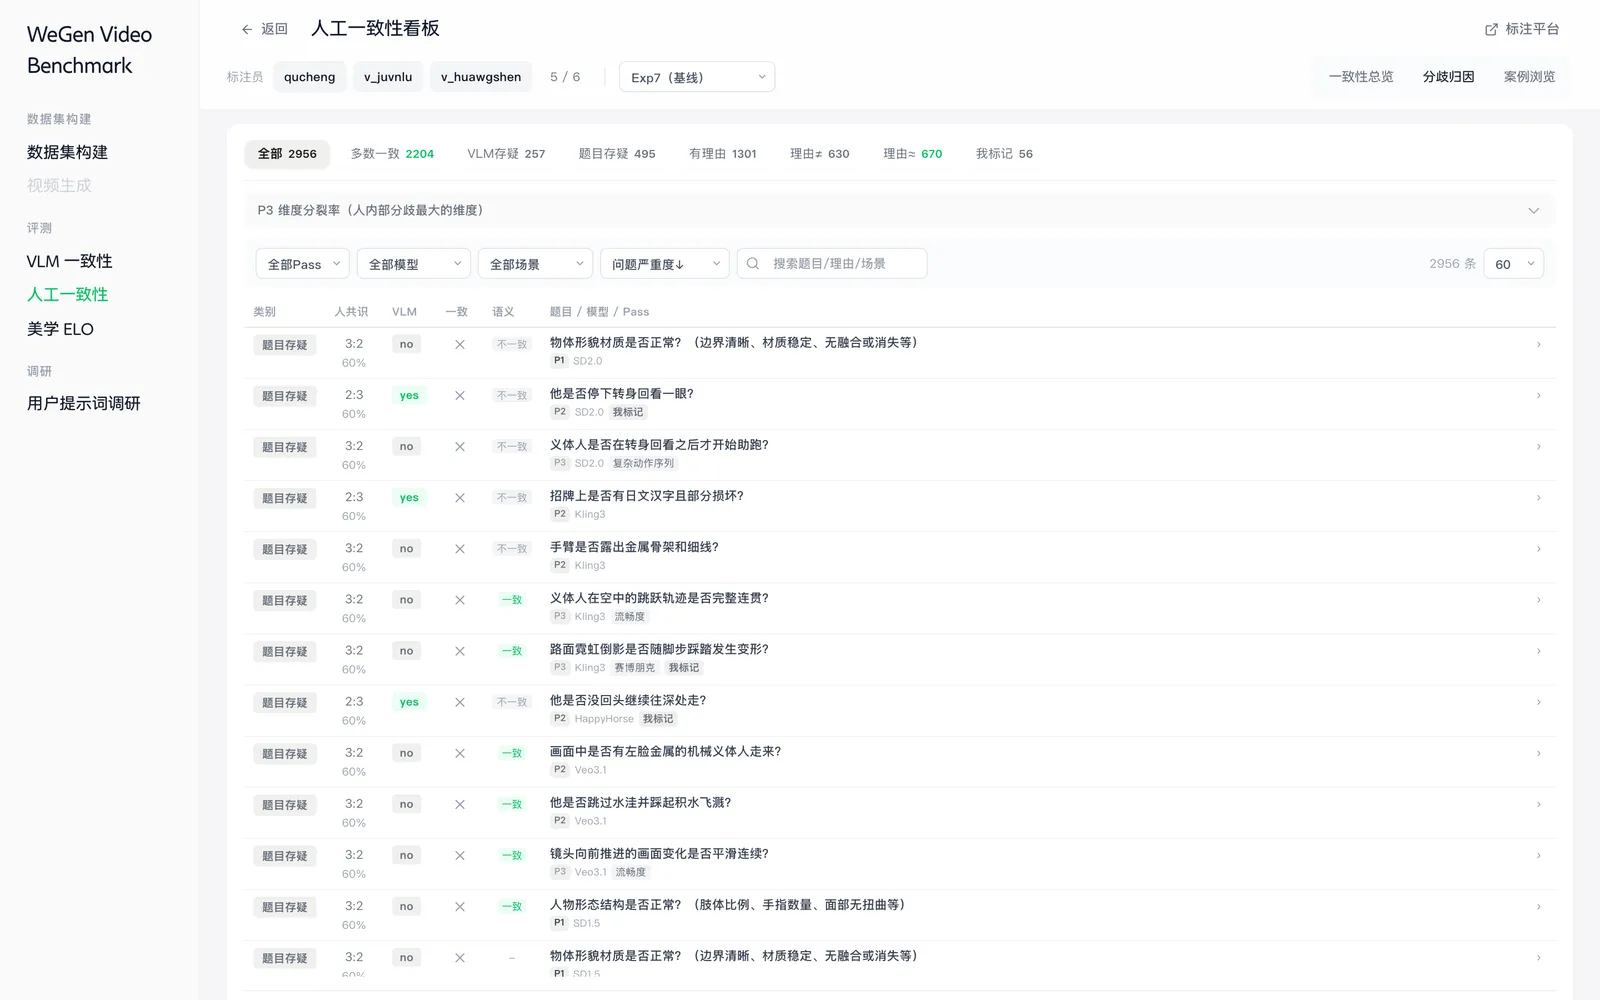
图 12 分歧归因,2956 题逐题明细与筛选
七种偏差模式与排名偏差
分析 VLM 与人类判断不一致的 2956 题,归纳出 7 种偏差模式。
| 模式 | 占比 | 根因 | 可修复 |
|---|---|---|---|
| 缺陷幻觉过严 | 30% | VLM 倾向主动找茬 | 可修复 |
| 看不清即否定 | 15% | 帧采样不足漏采瞬时动作 | 不可 |
| 照抄 prompt 过松 | 12% | 因 prompt 写了就默认成立 | 可修复 |
| 镜头方位 | 10% | 自我运动估计能力弱 | 不可 |
| 无声即无 | 8% | 听不到音频就判否 | 不可 |
| 动作因果链 | 8% | 时序推理弱 | 部分 |
| 语义严格度 | 7% | 对模糊表述理解过严过松 | 部分 |
偏差模式并非全无解法,缺陷幻觉过严通过“疑罪从无”的正面问法缓解,照抄 prompt 过松靠禁止脑补约束,动作因果链拆分原子化,语义严格度靠复合拆分。真正不可修复的部分属于模型能力天花板,只能通过出题规避。Pass1 的 YES 偏差对不同模型影响极不均衡,Kling3 被高估 11.2%、Veo3.1 被高估 3.9%,而 Horse 被严重低估 32.5%、Kling2.5 被严重低估 36.8%。根因是 VLM 把 Horse 的动画水彩风格视觉当质量缺陷判否,人类则认为只是风格差异;画面干净的模型几乎不受影响,风格化或粗糙画面的模型被严重拖累。这提示美学类判据不能直接套用指令遵循的评分框架,也为后续 ELO 美学评测独立成线提供了直接依据。
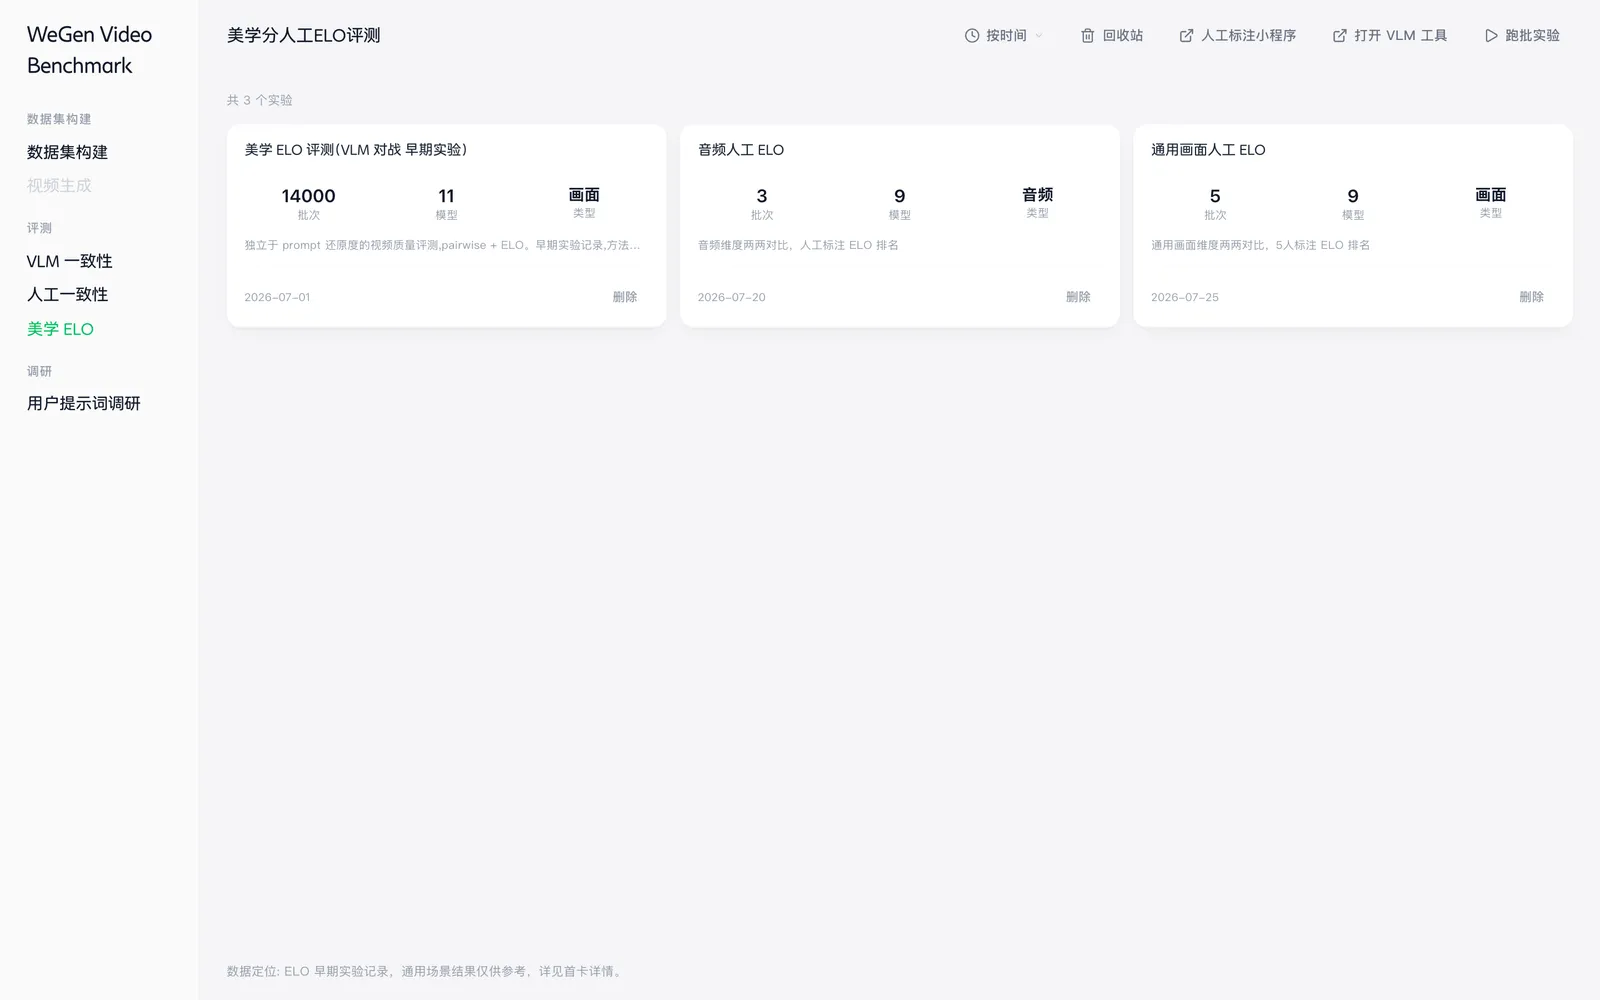
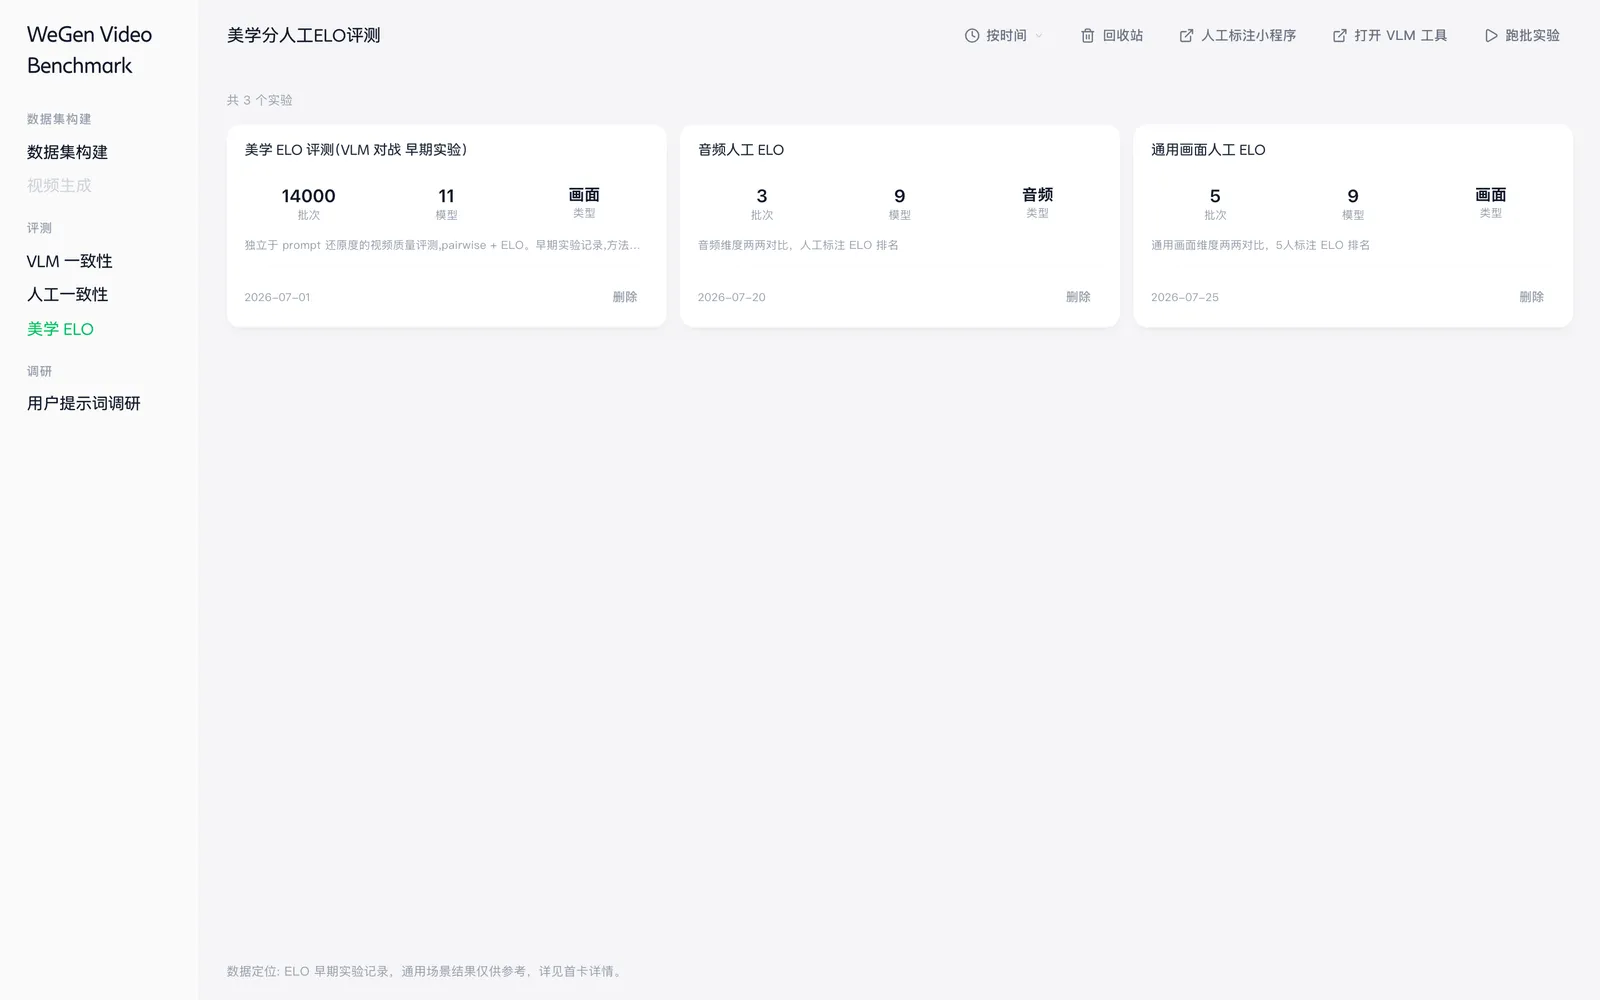
图 13 美学 ELO 评测,画面与音频双榜实验
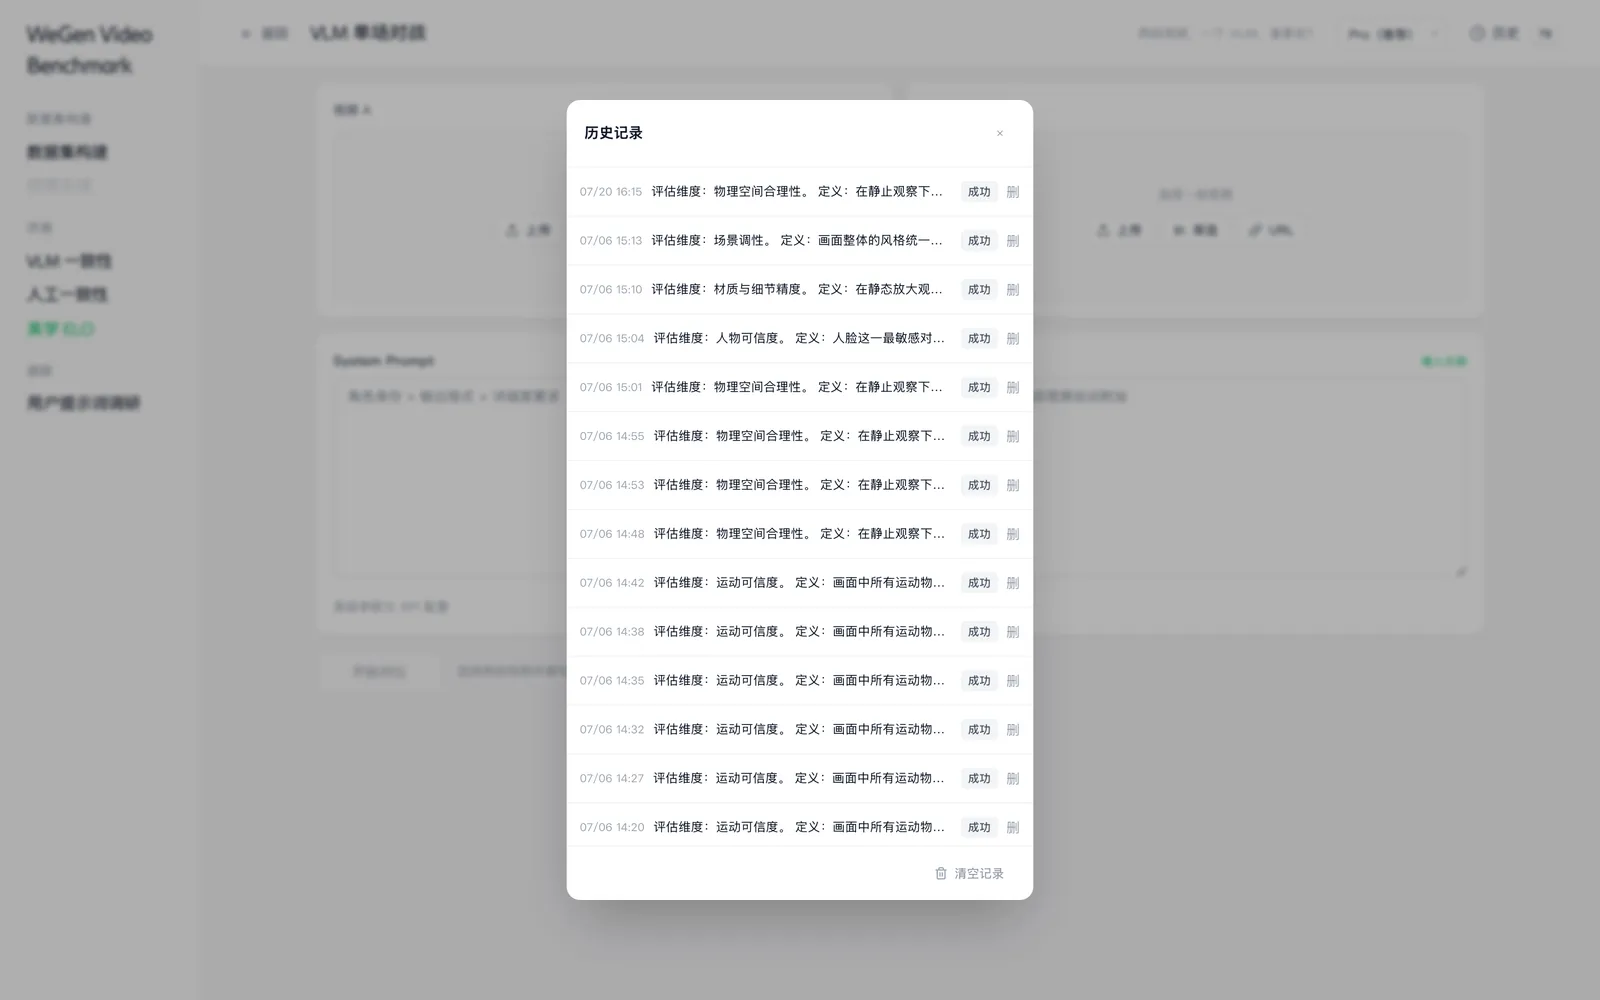
图 14 VLM 对战时,选择历史记录与评估维度,辅助批量对战
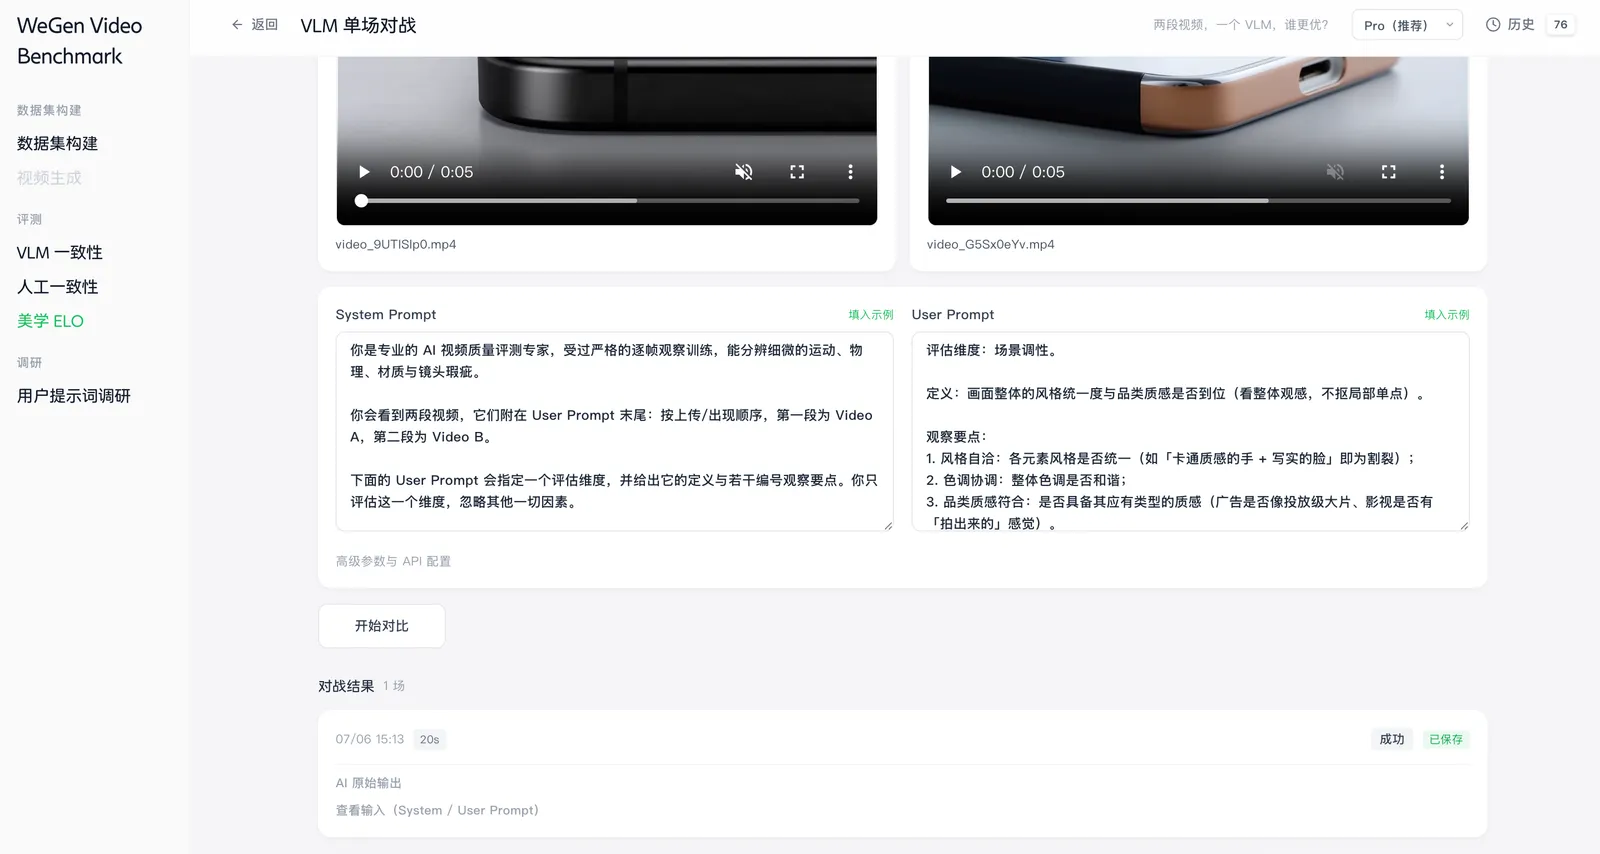
图 15 历史对战记录,单场结果与 ELO 变化
独立的美学评测与 ELO 引擎
VLM 在指令遵循评测上表现不错,在美学判断上效果不佳。“好看”是高度主观的判断,人类之间都常有分歧,指令遵循评测的高一致率在美学上并不成立。经过多轮尝试最终决策,放弃 VLM 自动化美学评测,回归人工两两对比,音频与画面分开两个独立数据池分别排名。
链接:美学 ELO 评测
ELO 引擎基于国际象棋评级算法。
每段视频初始 1200 分,按双方分数计算胜率预期,分差 400 分时高分方胜率约 91%;标注选择胜负平后,新分等于老分加 K 乘以 1 减预期胜率。两两对比的代价是标注量级比直接打分更大,但标注员只需二选一,判断标准单一。三阶段配对将海量两两比较压缩到可控规模,音频榜与画面榜独立成池,得到各模型可复现的 ELO 分数,对战结果沉淀为榜单数据,前端看板实时呈现每个模型的分数与排名变化。
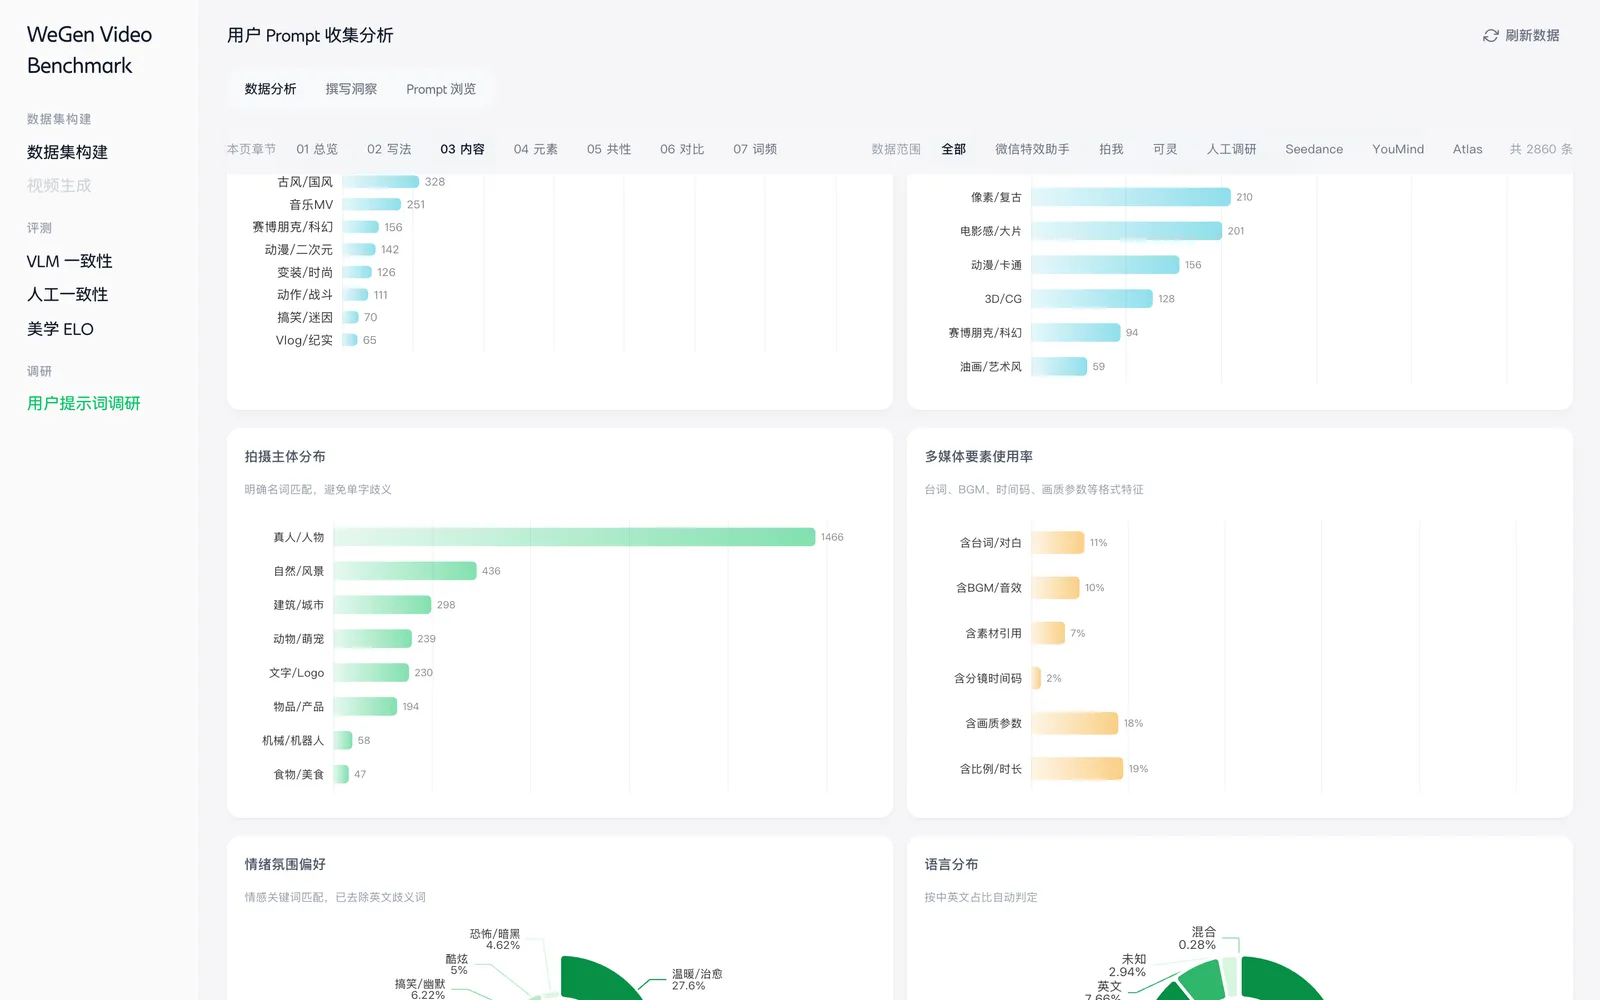
图 16 写法模式与长度分布
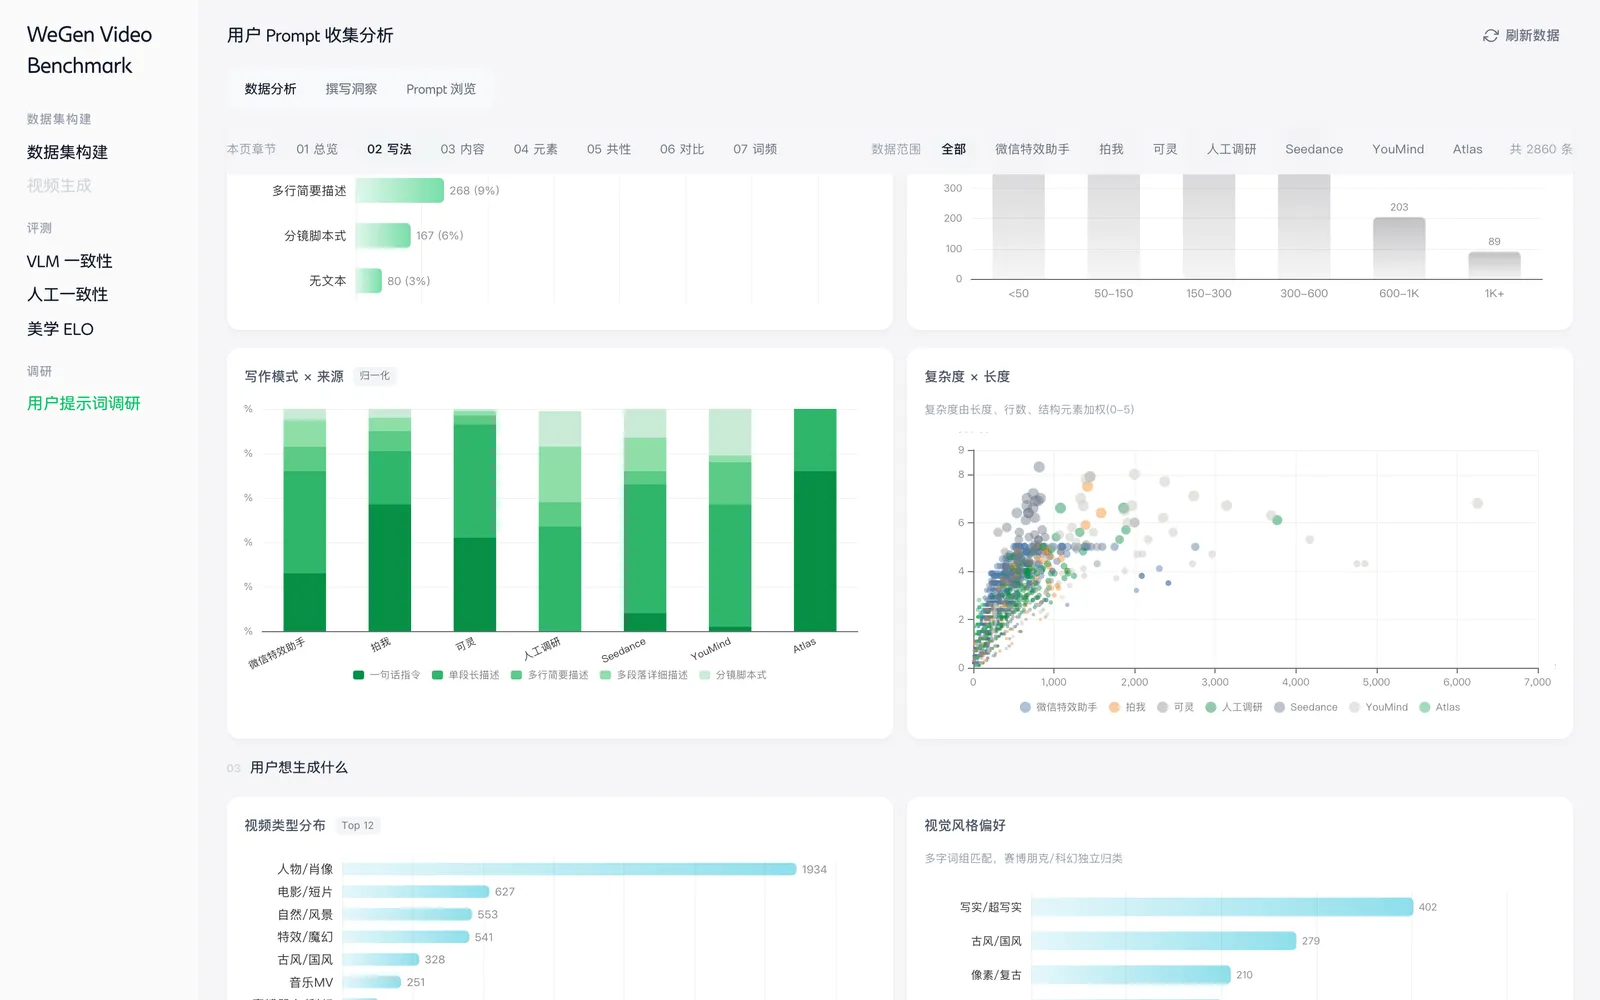
图 17 数据来源构成,7 平台样本占比
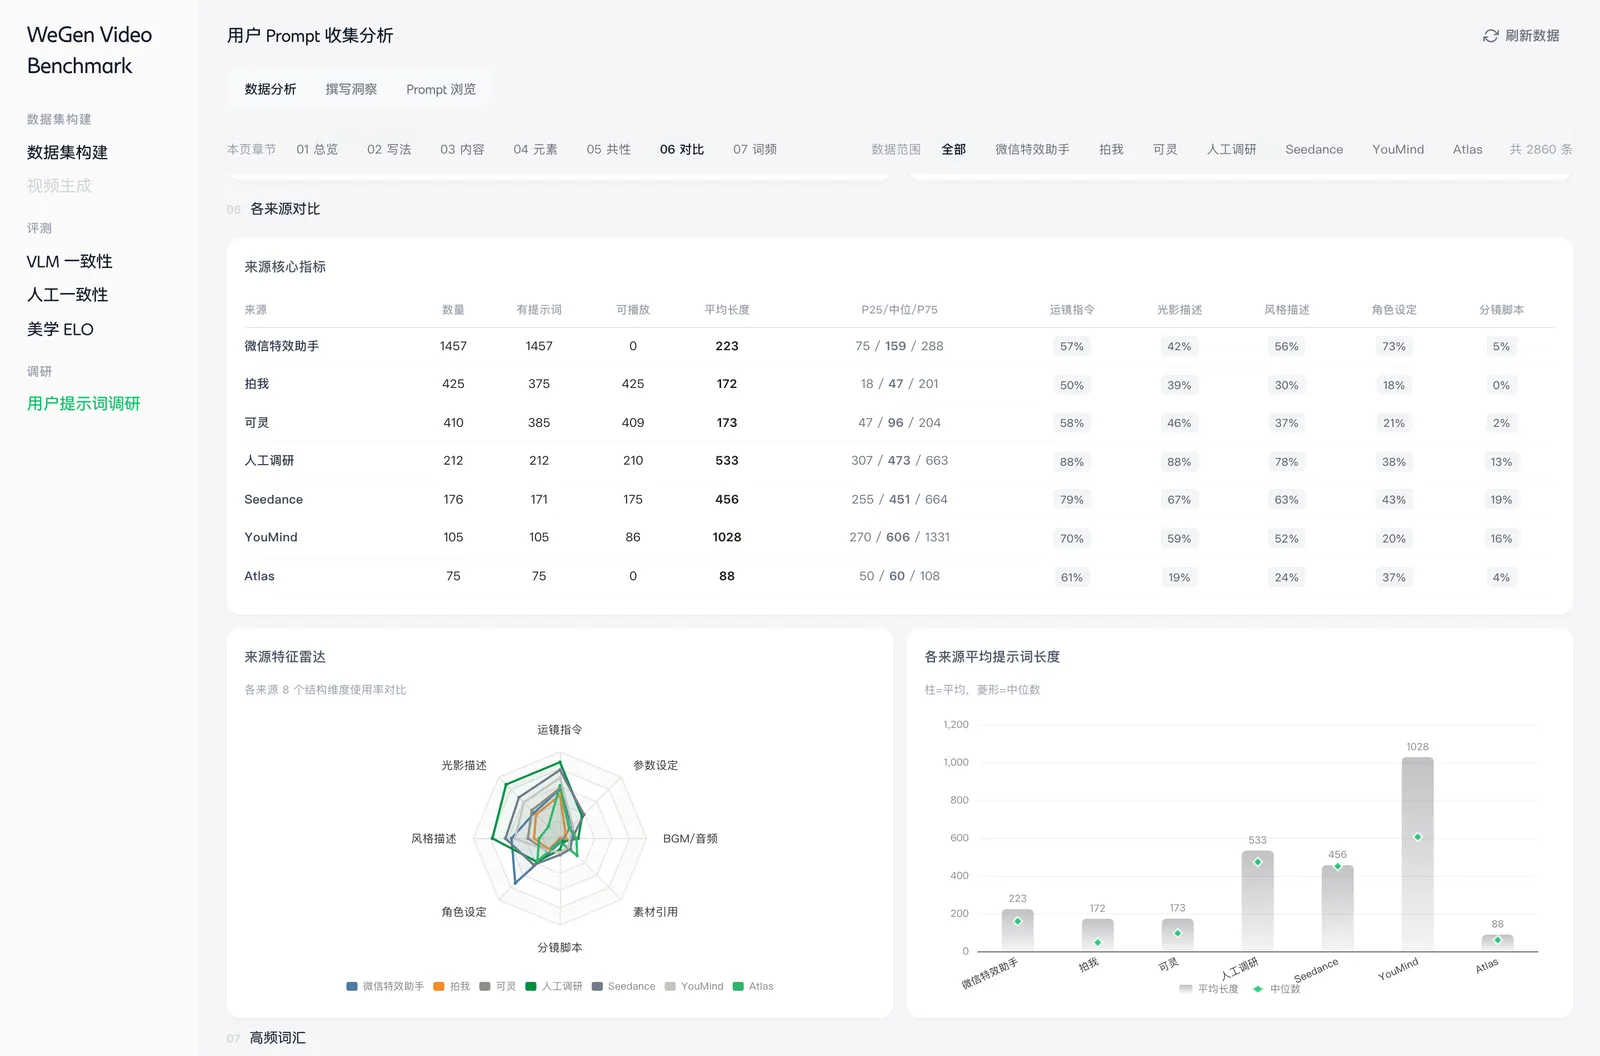
图 18 各平台写法对比
用户 Prompt 数据分析
从 7 个平台爬取 2780 条真实用户 Prompt,回答“用户实际怎么写 Prompt”。
链接:用户提示词调研
| 指标 | 数值 | 含义 |
|---|---|---|
| 自然段落 | 81% | 用户倾向自然语言描述 |
| 关键词堆砌 | 11% | 少数用户关键词堆砌 |
| 中位数长度 | 约 160 字符 | 用户 Prompt 普遍简短 |
| 包含主体 | 89% | 绝大多数描述主体 |
| 包含动作 | 87% | 绝大多数描述动作 |
| 包含场景 | 76% | 约四分之三描述场景 |
| 人物肖像类 | 69.5% | 最主要的视频类型 |
样本来源覆盖微信视频号、Kling、PaiVideo、Seedance 等 7 个平台。这些结论直接指导 Prompt 构建策略,控制长度在 150 到 400 字符区间,以自然段落为主,确保每条包含主体、动作、场景三要素。人物肖像类占 69.5%,提示人像维度必须给足出题权重,避免评测与真实使用场景脱节。
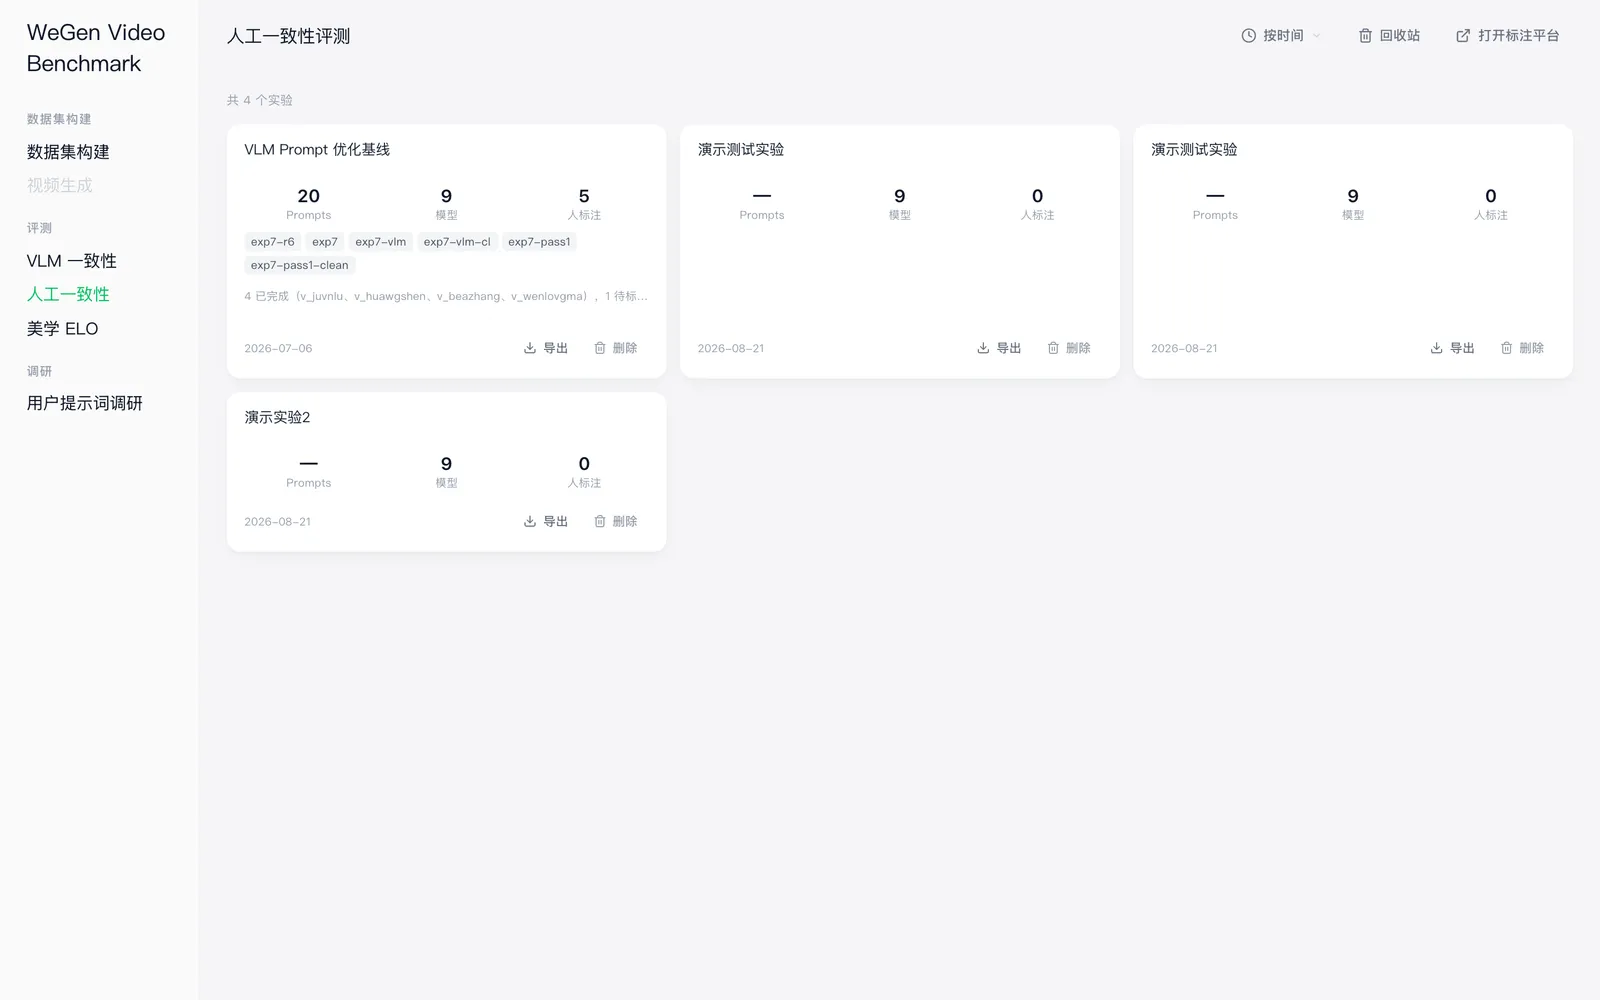
图 19 人工一致性模块入口,实验发布与进度
评测平台总览
所有评测工作围绕一个可运行的评测平台展开,前端 Vue 3 单页应用,后端 Node.js Express,数据侧 Python 管线,覆盖 Prompt 构建、视频生成、VLM 评测、人工验证、ELO 排名、Prompt 分析六个环节。五个核心模块对应五个一级路由,数据集构建、VLM 评测、人工一致性、ELO 美学、Prompt 分析。
平台共享一批通用组件,CardShell 统一卡片外壳、TrashDrawer 回收站支持软删除与还原、SkeletonCards 骨架屏、VideoPreview 视频预览。全局还有一个跑批进度条,通过 SSE 实时推送后端进度;模块按需懒加载,进入对应模块才下载代码。平台化让评测链路可复现,同一份配置、同一批题目,任何时间重跑都能得到相同结果。
平台沉淀了 2026-07 全量评测的真实数据:1289 条 Prompt × 9 模型 × 11552 个视频,站内按实验逐条可查。五个模块共享同一套设计语言与组件库,新增功能不需要重复造轮子。平台从立项起就沉淀设计语言规范,五个模块的页面底色、选中色、字号、圆角、阴影全部统一。
数据集构建模块
数据集构建是 8 步 Pipeline 的前端入口,采用列表、查看、创建三态切换外壳,不拆成多个路由。新建数据集在 GenerateConfigTab 配置页上完成。
链接:数据集构建
- 维度配置,按评测维度分配生成任务,可设置每条维度的生成数量与随机种子;
- 维度词库,DimEditor 可视化编辑 49 维定义,LeafSelector 选择到叶子维度;
- 模板配置,选择 Prompt 模板与候选池,预览生成结果;
- 导出,ExportDialog 支持字段过滤与格式选择。
配置完成后一键跑批,SSE 实时推送每步进度与当前正在生成的 Prompt 内容,长任务可中断续跑,跑批期间可以切走查看其他模块,进度不会丢失。结果以 JSON 卡片列表呈现,支持逐条查看与编辑,MatrixView 以矩阵视图展示维度覆盖情况。跑批历史沉淀在 BatchOverviewTab,可回溯每次生成的任务参数与产出;回收站承接误删数据的还原,数据从构建到使用的生命周期都在一个页面内闭环。
VLM 与人工一致性看板
VLM 模块以实验为组织单位。实验列表展示每次实验的状态卡,进入详情页后呈现多组图表,模型排名、排名稳定性、各维度正确率排名、三类题目的 Checklist 对比、批量判题与逐题判题对比、与 AA Benchmark 的散点对照。案例浏览支持按 Prompt、模型、维度筛选,逐条查看视频、题目与 VLM 答案,Prompt 卡片标注坐标信息。实验配置、参数与结果通过 exp 路由与 runs 浏览器关联,8 轮实验的演进一目了然。
链接:VLM 一致性评测
人工一致性模块以实验卡片列表进入分析看板,看板按三个 Tab 组织,一致性总览、分歧归因、案例浏览。总览页聚合关键指标,VLM 与人一致率、标注员间一致率、标注进度、全票 5:0 题目数;分歧来源按 Pass、模型、维度排名,左半区即薄弱点;共识矩阵把共识程度 5:0、4:1、3:2 与 Pass 交叉,灰条为人类基线、绿条为 VLM,差距一目了然。共识程度越高的题,VLM 一致率越高,人类本身都分裂的题才是 VLM 上限的真实瓶颈,为聚焦出题质量提供了量化证据。看板支持按标注员与 VLM 来源筛选,标注平台作为独立页面外链打开。
技术架构与设计语言
平台采用前端、后端、Python 管线三层架构,评测链路完整闭环。
工程上按前端、后端、Python 管线三层落地,前端用 Vue 与 Tailwind 定制微信绿主题、图表双引擎,后端按模块拆路由、SSE 统一封装,模块懒加载。平台化的收益在于评测链路可复现,同一份配置、同一批题目,任何时间重跑都是相同结果,实验差异只来自题目与模型本身。设计语言沉淀为一份规范文档(三层灰白体系、微信绿选中态、统一字号与圆角),空状态、加载骨架、回收站统一标准,新模块直接复用。
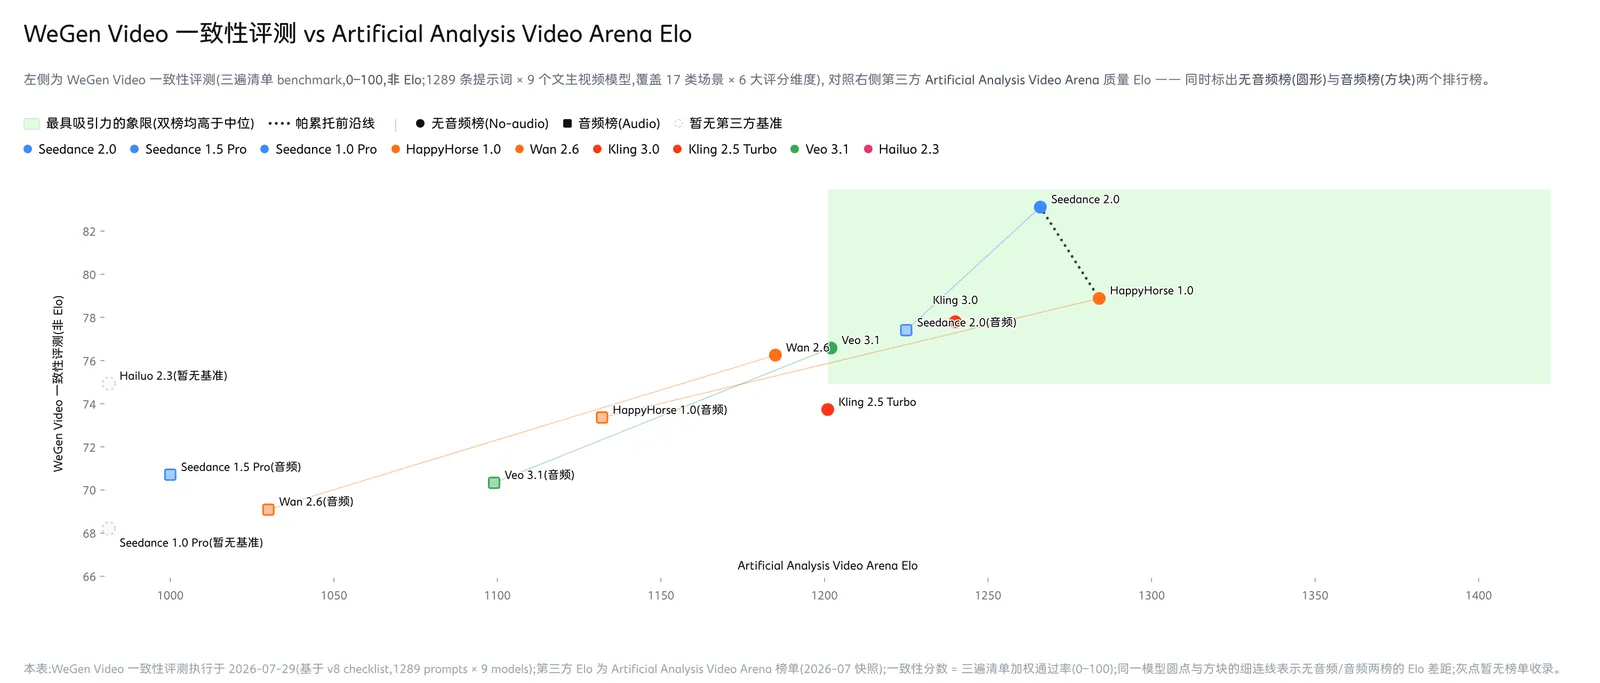
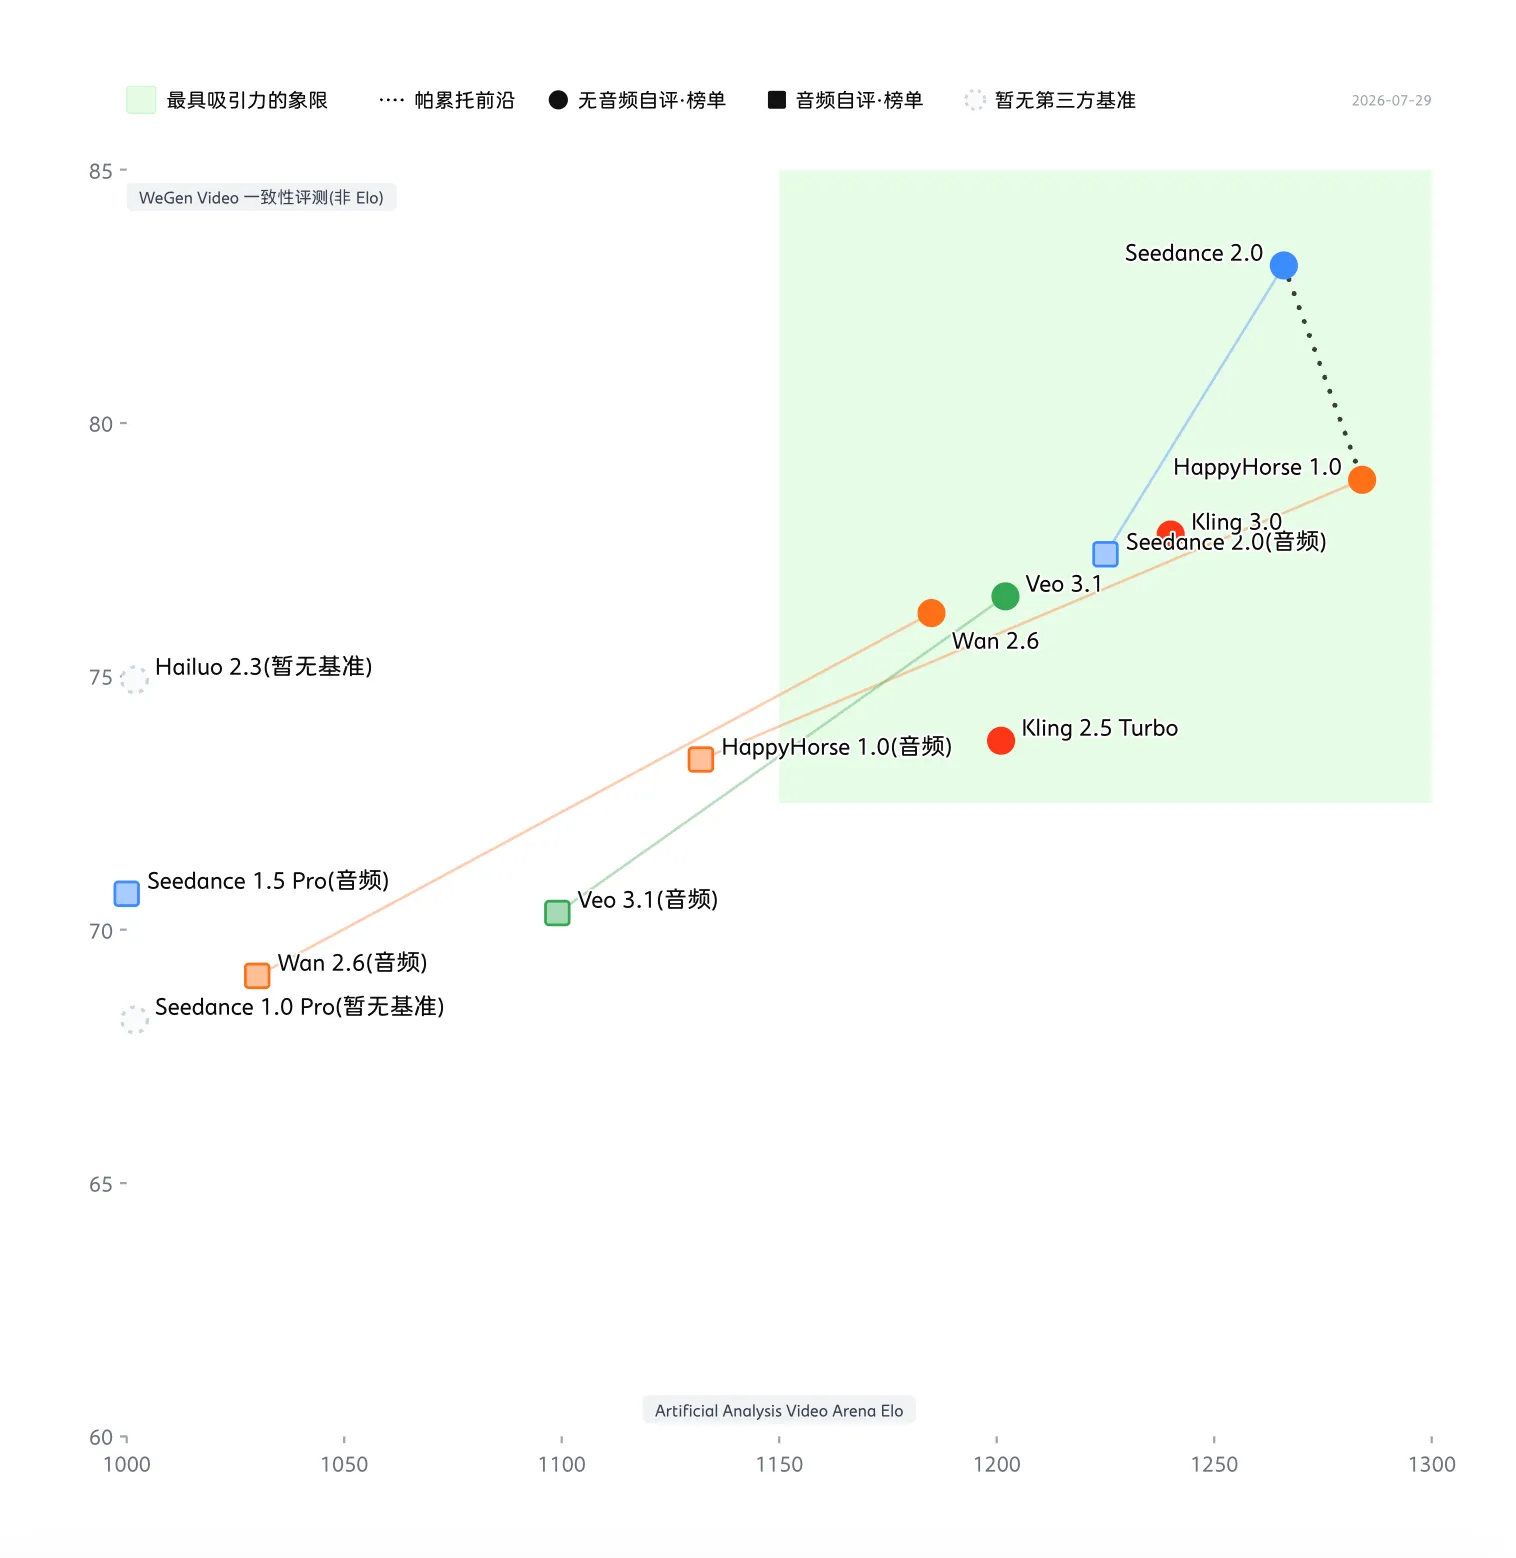
图 20 自评两口径与 AA Elo 的全量对比快照 2026-07-29
V8 vs AA Benchmark 榜单对比
用 V8.0 全量数据集跑完 9 个模型共 11552 个视频的评测。9 个模型包括 Seedance 2.0、HappyHorse 1.0、Veo 3.1、Wan 2.6、Kling 3、SD 1.5、MiniMax、Kling 2.5T、SD 1.0。与行业标杆 AA Benchmark 对比,音频榜 5 个模型 Spearman 相关系数 100%,排名完全一致;无音频榜 6 个可比模型中仅一半一致,Spearman 50%。
判据分析揭示两条评测线的互补关系。
| 判据 | 结论 |
|---|---|
| Veo 美学 vs Wan | Veo 美学明显优于 Wan,指令遵循几乎一样 |
| Kling3 vs Wan | Kling3 画面观感明显优于 Wan,Checklist 体现不出 |
Checklist 测的是纯客观的指令遵循能力,AA-ELO 包含美学与观感等主观维度,两者结合才能全面评估模型。音频榜的满分对齐说明客观判据与人类审美在音频维度高度吻合,无音频榜的半一致则暴露出主观观感判据的体系差异,这正是两类评测线需要并存的理由。
关键数据汇总
| 维度 | 数据 |
|---|---|
| 评测维度 | 49 维,10 类主体 × 27 项能力 |
| 评测 Prompt | 1289 条,V8.0 最终版本 |
| Checklist 题目 | 19922 道,tpl 22% / ce 47% / cl 31% |
| 生成视频 | 11552 个,9 模型 × 1289 条 |
| 人工验证 | 5 人标注 2956 题,一致率 80%+ |
| VLM 上限 | 已发挥理论潜力 97%,88.4/91.0 |
| 榜单对比 | 音频榜 Spearman 100%,无音频榜 50% |
| 用户调研 | 7 平台 2780 条用户 Prompt |
复盘
VLM 评测有明确边界,知道边界比追求自动化更重要。它在指令遵循、内容要素核查、客观维度考核上表现良好,在需要主观感受的美学判断上效果不佳,这是 ELO 评测独立存在的原因。
这套体系最大的价值,是让“模型好不好”有了可量化、可复现的衡量方式,可以客观比较模型差异、追踪迭代变化、定位短板,并与行业基准对标。
过程里也有教训。从 Prompt 构建到人工标注,各环节的编号与记录没有统一,导致一条 Prompt 从生成到出分的完整链路无法自动追踪,跨模块需要人工拼接。如果重来,会从源头统一编号与实验档案,更早做小规模人工验证,并让实验的配置、参数、结果自动关联,而不是靠事后补文档。